
来源:HTB Academy「Cracking Passwords with Hashcat」,模块 20,全部 14 小节。2026-10-10 阅读整理。按概念、条件、操作、验证与限制归纳,不照搬终端长输出。命令仅供课程实验或明确授权的离线评估;本次没有执行破解、启动实验或提交答案。
配图使用课程原始 HTTPS 图片,联网且阅读器允许加载远程图片时才能显示。工具教程来自课程正文及正文明确链接的相关官方文档;没有提供的环境步骤不自行补造。课程旧版本、性能数字不是当前环境的保证。
学习主线与目录
先辨认哈希和输入格式,再选择候选生成方式,最后观察恢复结果;不要把“生成了候选”误当作“破解成功”。
阶段 小节 要解决的问题 基础 1–4 破解的含义、哈希与加密、识别算法、安装 Hashcat 候选生成 5–8 字典、组合、掩码、混合模式如何取舍 定制候选 9–10 根据对象生成字典,用规则扩展词形 实际输入 11–13 系统哈希、加密文件、无线捕获如何交给 Hashcat 综合练习 14 按已知背景识别并恢复多类哈希
通用流程:授权范围与输入来源 → 算法/格式确认 → 有针对性的字典与规则 → 小范围预览/测试 → 查看进度和恢复结果 → 根据成本调整策略。
1. 介绍:密码破解概述
密码破解在本章主要指离线尝试候选密码:计算候选对应的结果,与已取得的哈希比对,找到匹配的明文。它不是对哈希执行某个“解密函数”。
弱密码和密码复用是课程强调的两个风险。候选可以来自常见密码字典,也可以根据企业名称、人员信息、密码政策定制,再用规则变化。对安全评估人员,它帮助判断已获得的哈希能否支持后续授权工作;对防御人员,它解释为什么“只存哈希”仍不足以抵御弱密码风险。
本节是概念引入,未给安装或具体命令;Hashcat 首次使用见第 4 节。没有正文教学图片。
2. 哈希与加密
核心区别
对象 核心性质 本章中的用途/例子 哈希 同一算法通常输出固定长度;不能直接逆运算还原;可能发生碰撞 候选计算后比对;MD5、SHA256 用于完整性示例 带密钥的完整性计算 计算中引入密钥 HMAC,用于消息完整性验证 密码专用处理 增加每次猜测成本 PBKDF2、bcrypt;课程还概述 Argon2 的资源成本 对称加密 加密与解密使用相同秘密密钥 XOR 演示;AES、DES、3DES、Blowfish 公私钥体系 使用公钥、私钥承担不同角色 课程概述非对称体系,本章不展开协议实现
哈希长度只能帮助筛选,不能证明算法。盐是与密码处理相关的额外数据:相同密码配不同盐可以得到不同结果,降低预计算结果的复用价值;盐并不使弱密码不可猜测。慢速算法与盐的作用也不能混为一谈。
演示一:输入变化导致摘要变化
前置:课程 Unix shell 环境,已有 md5sum;本节未提供其安装教程。
echo -n 'p@ssw0rd' | md5sum
echo -n 'p@ssw0rd123456' | md5sum
-n 避免加入换行,两次输入不同,摘要也应不同。这里只演示拼接盐改变输入,不是完整的生产密码存储方案。原页摘要输出存在长度疑点,故不抄作校验答案,以实际命令输出为准。
演示二:XOR 的可逆性
前置:Python 3,并能导入 pwn 模块;课程没有给该模块安装命令,也没有要求额外认证或网络连接。
from pwn import xor
ciphertext = xor('p@ssw0rd', 'secret')
print(ciphertext)
print(xor(ciphertext, 'secret'))
第二次用同一密钥处理,课程结果为 b'p@ssw0rd';b 表示字节串。此例用来理解可逆加密,不代表 XOR 是安全密码存储方式。
注意:原页对 Blowfish、密码哈希及公钥算法的分类有概述性混用;学习重点是“候选比对”和“持有密钥解密”不同,不据此推导全部算法或 HTTPS 的完整实现。没有正文教学图片。
3. 哈希识别
先看结构,再结合来源
32 个十六进制字符可能是 MD5,也可能是 NTLM。hash:salt、salt$hash 等结构提供更多线索;还要结合它来自 Windows、Linux、数据库或特定应用的背景。
前缀/结构线索 课程对应类型 Unix MD5-crypt 、 bcrypt/基于 Blowfish 的密码处理格式 Unix SHA256-crypt Unix SHA512-crypt,不是原始 SHA512 摘要 Apache MD5 格式 WordPress 等使用的 PHPass 格式线索 Domain Cached Credentials 2
hashID:首次使用与操作
环境:Python、pip。用途:根据格式给出候选算法,可处理单个字符串或文件;识别结果不是唯一结论。来源:课程链接的 hashID 项目。
pip install hashid
hashid '$apr1$71850310$gh9m4xcAn3MGxogwX/ztb.'
hashid hashes.txt
hashid '$DCC2$10240#tom#e4e938d12fe5974dc42a90120bd9c90f' -m
单引号保护 $,避免 shell 把哈希内容当作变量。-m 请求对应 Hashcat 模式,课程 DCC2 示例返回 2100。文件中保存完整哈希,不填网页里的截断标记。
首次配置:本节没有额外配置文件步骤。验证方式是检查工具是否解析出候选,再对照Hashcat 示例哈希表和来源系统;不能只选输出列表中的第一项。课程以 LastPass 的 6800 为例说明上下文和完整字段的重要性。
4. Hashcat 概述与首次环境准备
安装、环境与初次检查
课程主要使用 Pwnbox/Parrot 的 Linux shell,也展示 Windows/Linux 官方发行包。以下 apt 命令需要安装软件的权限:
sudo apt install hashcat
hashcat -h
hashcat --example-hashes | less
hashcat -b -m 0
帮助输出用于核对当前版本支持的参数;--example-hashes 查看算法与格式,less 中按 q 退出;-b -m 0 测试 MD5 性能,单独 hashcat -b 测全部基准。
也可从课程链接的官方网站取得发行包并解压,或使用源码。原页 6.1.1 是历史演示版本,不当成“最新版”。发行版仓库更新与官方发行不是同一件事。课程展示 OpenCL/CPU 后端与性能,但没有完整 GPU 驱动安装流程,因此这里不补造驱动教程。
使用前必须准备:格式正确的哈希文件、与算法对应的 -m、字典/掩码/规则,以及可工作的计算后端。本章离线示例通常不需要连接目标服务或输入 SSH 凭据;提取材料的授权与权限另看相应小节。
模式选择
参数 作用 -m 哈希类型编号,不是攻击方式 -a 0 字典(straight) -a 1 两个字典的组合 -a 3 掩码 -a 6 字典 + 掩码(后缀) -a 7 掩码 + 字典(前缀)
后续 Linux 示例统一用下列字典变量,路径来自课程 Pwnbox。若没有该文件,应使用自己已有、获准使用的字典,而不是假定安装 Hashcat 就会附带它:
WORDLIST=/opt/useful/seclists/Passwords/Leaked-Databases/rockyou.txt
性能选项与结果判断
-O 使用优化内核,但可能限制可尝试密码的长度;具体限制取决于模式,不能把课程举出的长度当通用上限。可先尝试优化模式,再处理未覆盖的长密码。
-w 调整负载:课程默认 2,日常桌面可考虑 1,专用破解机器可考虑 3。不要无条件使用 --force 绕过后端警告,课程指出这可能造成不可靠结果,应先处理根本环境问题。
观察 Status、Recovered、Progress、Speed、剩余时间:Cracked/恢复数量说明命中;Exhausted 只说明当前候选集用完,不证明密码无法恢复。课程输出的秒数和速度依赖硬件与算法,不能作为复现承诺。
5. 字典攻击
目标是先测试较可能的密码,而不是遍历所有字符串。适用于常见弱密码、泄露字典中出现过的词;课程提到 SecLists、rockyou、CrackStation。大字典占用更多存储和时间,未必优于小而相关的字典。
安装与后端条件见第 4 节;首次配置是选好字典路径和算法。先用课程已知密码生成练习哈希,再验证整个流程:
echo -n '!academy' | sha256sum | cut -f1 -d' ' > sha256_hash_example
hashcat -a 0 -m 1400 sha256_hash_example "$WORDLIST"
1400 是原始 SHA256,-a 0 逐行读取候选。课程示例命中 !academy,应以 Cracked、Recovered 1/1 和恢复明文判断结果,不能只看程序启动。
课程随后将同样的密码放在 bcrypt 示例中,展示算法成本差异:同一字典、同一密码并不意味着耗时一样。不要把 bcrypt 的成本字段 05 解释成“只运行五轮”,也不要在慢速模式中照搬大型字典的预计完成时间。优先缩小候选范围,规则扩展见第 10 节。
运行提示中 s 查看状态、p 暂停、b 跳过当前攻击、c 设置检查点退出、q 退出;按当前版本实际提示操作。
6. 组合攻击
适用场景:密码可能由两个有意义的词直接拼接。把两个字典做笛卡尔积,左边词在前、右边词在后;不是把两个文件的行简单合并。
前置:第 4 节环境,以及两个已有文本字典。课程示例左侧包含 super/world/secret,右侧包含 hello/password,共 3 × 2 = 6 个候选。可先预览再破解:
hashcat -a 1 --stdout wordlist1 wordlist2
echo -n 'secretpassword' | md5sum | cut -f1 -d' ' > combination_md5
hashcat -a 1 -m 0 combination_md5 wordlist1 wordlist2
预览应包含 secrethello、secretpassword;破解示例命中 secretpassword。两个字典顺序交换后,生成的是另一组候选。字典越大,乘积越大;小示例的工作量不足以充分利用 GPU 属于性能提示,不自动代表命令失败。
7. 掩码攻击
已知密码的部分结构时,固定已知位置,只枚举未知位置,比完全无约束穷举有效。例如企业前缀 + 五个小写字母 + 某一范围年份。
占位符 字符范围 ?l / ?u 小写 / 大写英文字母 ?d 十进制数字 ?h / ?H 小写 / 大写十六进制字符 ?s 特殊字符,含空格 ?a ?l?u?d?s 的集合 ?b 全字节范围 ?1–?4 由 -1–-4 定义的自定义集合
前置:正确的长度、固定片段及字符范围假设;环境见第 4 节。课程实例将年份限制在 2000–2019:
echo -n 'ILFREIGHTabcxy2015' | md5sum | tr -d ' -' > md5_mask_example_hash
hashcat -a 3 -m 0 md5_mask_example_hash -1 01 'ILFREIGHT?l?l?l?l?l20?1?d'
ILFREIGHT 和 20 是字面值,五个 ?l 各占一个位置;-1 01 将年份十位限制为 0 或 1,最后 ?d 取 0–9。候选数为 26^5 × 20 = 237627520。掩码需要引号,不能把正则表达式 [0-1] 直接替换成 Hashcat 掩码语法。
课程还介绍 --increment 和 --increment-max 控制增长长度,使用前核对帮助及课程链接的掩码文档。验证既看命中结果,也看输出的掩码和候选规模是否符合自己的假设。
8. 混合模式
适合“常见词 + 小范围变化”。把词根交给字典,固定位置的数字或符号交给掩码;安装见第 4 节,配置只需选对前后顺序。
# 字典词后追加一个数字和一个特殊字符
echo -n 'football1$' | md5sum | tr -d ' -' > hybrid_hash
hashcat -a 6 -m 0 hybrid_hash "$WORDLIST" '?d?s'

# 字典词前添加 2000–2019 的年份
echo -n '2015football' | md5sum | tr -d ' -' > hybrid_hash_prefix
hashcat -a 7 -m 0 hybrid_hash_prefix -1 01 '20?1?d' "$WORDLIST"
课程结果分别是 football1$ 和 2015football。区别不只是编号:-a 6 的字典在前、掩码在后,-a 7 相反。字典必须包含对应词根;选错位置、年份范围或词根,候选再多也可能无法命中。
9. 创建自定义字典
根据密码政策、已授权获知的人员信息、键盘路径、企业网站用语或已恢复密码建立候选。原则是提高相关性,避免只追求文件大小。生成工具并不自行验证哈希;其输出要交给 Hashcat 的字典/规则模式。
9.1 Crunch:按长度和模板生成
课程说明 Parrot 环境已有 Crunch,并链接项目,未提供通用安装步骤。初次配置:确定长度、允许字符、输出文件和可用磁盘空间。
crunch 4 8 -o wordlist
crunch 17 17 -t ILFREIGHT201%@@@@ -o wordlist
首例生成长度 4–8 的候选,可能产生巨大文件;第二例固定模板,% 表示数字、@ 表示小写字母,固定长度为 17。课程还说明逗号表示大写、^ 表示符号,-d 用于限制重复;具体值要核对所用版本帮助,不把未核验的重复限制语法当通用配置。
验证:检查生成文件内容、长度、大小是否符合模板;这种方法适合已知格式,而非无限扩大穷举范围。
9.2 CUPP:人员特征字典
课程环境已有 CUPP。首次准备及配置依据课程链接的 CUPP README:需要 Python 3,配置文件为 cupp.cfg;在已有项目目录运行:
python3 cupp.py -h
python3 cupp.py -i
交互式输入姓名、昵称、生日、伴侣/孩子、宠物、企业名和关键词;未知字段留空,生日按提示的 DDMMYYYY。随后按提示决定是否添加数字、符号和 Leet 替换。课程 Roger 示例生成 roger.txt,得到 2419 个候选,这是示例数量而非固定结果。-l 可下载字典,需要网络;非交互式的详细配置不在本章展开。
适合已有授权背景信息的特定对象;完成后抽查候选是否确实包含所需关键词,不把个人资料字典当成必然命中。
9.3 KWprocessor:键盘路径
课程首次安装步骤:
git clone https://github.com/hashcat/kwprocessor.git
cd kwprocessor
make
环境:能够使用 Git 和 Make 编译。输入由 basechars、keymaps、routes 三类文件决定,分别描述起点、键盘布局和行走路线。课程使用的命令名是 kwp;如编译后没有这个 PATH 命令,要使用实际生成的可执行文件,不假定编译会自动全局安装。
kwp -s 1 basechars/full.base keymaps/en-us.keymap routes/2-to-10-max-3-direction-changes.route
-s 1 包含 Shift 相关变化;课程示例从 T 出发,向东、南、西移动生成 TYUJNBV。用于人们沿键盘走位构造的密码。先观察输出与键盘布局一致,再用于破解。相关 README
9.4 PRINCE:把词作为元素拼接
把输入词自动拼接为不同长度组合。课程的安装方式是下载并解压发行包,示例版本 0.22 仅作为课内历史版本:
wget https://github.com/hashcat/princeprocessor/releases/download/v0.22/princeprocessor-0.22.7z
7z x princeprocessor-0.22.7z
cd princeprocessor-0.22
./pp64.bin -h
./pp64.bin --keyspace < words
./pp64.bin -o wordlist.txt < words
./pp64.bin --pw-min=10 --pw-max=25 -o wordlist.txt < words
./pp64.bin --elem-cnt-min=3 -o wordlist.txt < words
前置:下载网络、7z 解压工具、能执行对应平台二进制,输入 words 一行一个元素。课程未给这些系统工具的安装流程。配置用 --pw-min/--pw-max 控制最终字符长度,--elem-cnt-min/--elem-cnt-max 控制组合元素数量,两者不同。先用 --keyspace 看规模;课程 dog/cat/ball 示例展示 232 个候选,不是任意输入都一样。课程发行包链接
9.5 CeWL:从网站提取企业用语
适合在获准访问的企业网站提取品牌、产品和行业词。初次准备可按课程链接的 CeWL README安装:需要 Ruby、Bundler 及项目依赖,相关元数据功能还要求 exiftool;课程没有给 Ruby/exiftool 的系统安装步骤。
git clone https://github.com/digininja/CeWL.git
cd CeWL
gem install bundler
bundle install
chmod u+x ./cewl.rb
./cewl.rb --help
./cewl.rb -d 5 -m 8 -e http://inlanefreight.com/blog -w wordlist.txt
最后一行保留课内网站作为示例,实际使用先确认授权及网络可达。-d 5 是爬取深度、-m 8 是最小词长、-e 提取邮箱、-w 保存字典;并非“词长一定大于 8”。如果已有系统命令,原页使用 cewl。源码运行无需为了此例强行创建全局软链接。验证输出中是否有相关词;深度增加会带来更多访问,不随意扩大到站外。
9.6 复用已恢复密码、辅助工具
课程将已恢复密码当作下一轮字典种子:观察企业的密码构造习惯,再配规则处理,而非机械重复同一批候选。
hashcat --show -m HASH_MODE hashes.txt
cut -d: -f 2- ~/hashcat.potfile
HASH_MODE 要换成正确编号;potfile 路径以实际环境为准,课程示例不是所有安装的固定位置。-f 2- 保留后续字段,避免仅取第二字段丢失密码中的冒号,但带多字段的哈希仍需要注意边界,不能把它当通用无损解析器。
课程另介绍 hashcat-utils 和 maskprocessor 作为字典处理/掩码候选辅助工具。后者示例为对 Welcome?s 枚举符号;在二进制所在目录可写 ./mp64.bin 'Welcome?s',文件名与平台必须对应。本节没有给 maskprocessor 的完整安装命令,不虚构额外包安装。hashcat-utils 的实际编译实例见第 13 节。
10. 使用规则
规则把字典词变成常见密码变体,适合首字母大写、字符替换、添加年份等模式。它不是正则表达式:规则是在改写候选,而不只是匹配文本。环境与安装见第 4 节;首次配置是编写规则文件并用 --stdout 检查。
规则 作用 l / u 全部小写 / 大写 c / C 首字符大写其余小写 / 首字符小写其余大写 t / TN 全部 / 指定位置切换大小写 r / d / q 逆序 / 整词重复 / 每个字符重复 zN / ZN 重复首 / 尾字符 N 次 { / } 左 / 右循环移位 ^X / $X 前置 / 后置字符 X sXY 把 X 替换为 Y
符号依据课程链接的官方规则文档核对,避免网页翻译把规则字母改成汉字。位置参数从 0 起。拒绝规则不能不加区分地放进普通 -r 规则文件;课内涉及的相关功能有 legacy 或 -j/-k 使用限制。
先验证变换,再运行破解
echo 'c so0 si1 se3 ss5 sa@ $2 $0 $1 $9' > rule.txt
echo 'password_ilfreight' > test.txt
hashcat -r rule.txt test.txt --stdout
顺序是首字母大写 → o/i/e/s/a 替换 → 追加 2019;预期得到 P@55w0rd_1lfr31ght2019。规则行用单引号保护 $,否则 shell 变量展开可能改变规则。
echo -n 'St@r5h1p2019' | sha1sum | awk '{print $1}' > rule_hash
hashcat -a 0 -m 100 rule_hash "$WORDLIST" -r rule.txt
ls -l /usr/share/hashcat/rules/
hashcat -a 0 -m 100 -g 1000 rule_hash "$WORDLIST"
-r 使用已有规则文件;-g 1000 随机生成规则,不保证覆盖目标变化。课程展示内置 best64、leetspeak 等,也链接外部规则集;选择相关规则,避免不加分析地加载全部规则。多个 -r 会组合不同规则文件中的规则,候选量可能显著增长,不等同于简单并列执行文件。
验证看预览候选、恢复明文和 Recovered;耗尽时先检查规则是否真的生成了想要的词形,再考虑增加规模。
11. 破解常见哈希
常用编号速查
模式 类型 输入注意点 0 MD5 原始摘要 100 SHA1 原始摘要 1000 NTLM 与 NetNTLM 不同 1800 SHA512-crypt 保留 、盐与摘要 3200 bcrypt 保留完整格式及成本字段 5500 / 5600 NetNTLMv1 / v2 保留完整挑战响应结构 13100 Kerberos TGS etype 23 对应票据类型,不适用于任意 Kerberos 输入
Hashcat 的安装与输出判断见第 4 节。以下材料均以已在授权范围内获得为前提,课程不是这些材料的完整获取教程。
数据库 SHA1
将数据库中的摘要保存为 SHA1_hashes,一行一个,不带 SQL 表格边框或字段标题:
hashcat -m 100 SHA1_hashes "$WORDLIST"
课程用九个词生成九条摘要作演示,最终 Recovered 9/9。重点是输入清洗与模式选择,不照搬数据库长输出;批量恢复后仍逐项对应用户与明文。
Linux shadow
shadow 每行用冒号分隔,第二字段是密码哈希,其他字段用于账号/老化等信息。读取系统材料需要相应权限,不假定普通用户能读取。课程 示例要把完整第二字段存为 nix_hash:
hashcat -m 1800 nix_hash "$WORDLIST"
示例恢复 password123。保留盐与 前缀,不把整条 shadow 记录直接当作纯哈希,也不误用原始 SHA512 模式。
NTLM
课程用 Python 3 演示 MD4 对 UTF-16LE 密码进行处理:
import hashlib
import binascii
digest = hashlib.new('md4', 'Password01'.encode('utf-16le')).digest()
print(binascii.hexlify(digest))
环境前置是该 Python/hashlib 后端支持 MD4;课程旧环境能运行,不代表所有现代环境默认支持。未给兼容修复教程,因此不补写。把产生的十六进制摘要保存为 ntlm_example,不要包含 Python 的 b'' 显示包装:
hashcat -a 0 -m 1000 ntlm_example "$WORDLIST"
示例恢复 Password01。课程在需要明文登录、无法采用所述其他方式的 RDP 场景下解释其价值;不要把该场景推导为所有环境中的通用限制。
NetNTLMv2
课程假定已经从 Responder 得到捕获材料;捕获操作不在本章展开,未给该工具的首次配置教程。将用户名、域、挑战值和响应保持完整,保存为 inlanefreight_ntlmv2:
hashcat -a 0 -m 5600 inlanefreight_ntlmv2 "$WORDLIST"
课程示例恢复 Database99。NetNTLMv2 是认证交换材料,不是模式 1000 所需的原始 NTLM 摘要。Kerberos 在此主要提供编号线索,综合应用见第 14 节,不自行补写抓取票据命令。
12. 破解加密文件与其他哈希
统一思路:已获授权的文件 → 对应提取器 → Hashcat 能接受的完整哈希字段 → 正确模式 → 字典/规则 → 检查恢复结果。Hashcat 不应直接读取 DOCX、ZIP、KDBX 或 PDF 当作普通摘要。
提取工具首次准备
课程使用 John the Ripper 的 *2john 工具,而不是要求用 John 执行最终破解。正文给出如下源码编译流程;这需要 Git、编译环境和安装权限,未列出的系统依赖不补造:
sudo git clone https://github.com/magnumripper/JohnTheRipper.git
cd JohnTheRipper/src
sudo ./configure && sudo make
Python 提取脚本需要对应 Python 环境;课程另链接 Python 版提取器及 KeePass 脚本,使用时确认实际脚本所在目录。例子的裸脚本名表示已在相应目录或能定位文件,不表示系统一定将其加入 PATH。课程项目链接
首次配置重点是正确选脚本和输出字段。提取输出可能带 文件名: 前缀或后置说明;只保存 Hashcat 要求的完整哈希,不能带 <SNIP>,也不能盲目截断包含冒号的格式。
Office 文档
python office2john.py hashcat_Word_example.docx
hashcat -m 9600 office_hash "$WORDLIST"
先将提取出的 ... 完整内容保存为 office_hash,移除文件名标签。模式 9400/9500/9600 分别对应课程列出的 Office 2007/2010/2013;其他 oldoffice 格式需另行匹配,不能只按扩展名选择。课程示例恢复 pa55word,并展示此类算法可能很慢。
ZIP 压缩包
课程先创建已知密码的练习 ZIP,再提取:
zip --password zippyzippy blueprints.zip dummy.pdf
zip2john blueprints.zip
hashcat -a 0 -m 17200 zip_hash "$WORDLIST"
中间步骤:保存完整 ... 字段为 zip_hash,去除文件名/额外元数据。笔记用 zip_hash 统一命名,避免原页沿用 PDF 文件名造成误解。结果示例为 zippyzippy。
格式与模式要匹配:11600 是 7-Zip,13600 是 WinZip,17200 是 PKZIP 压缩,17210 是未压缩,17220/17225 对应多文件/混合,17230 对应 checksum-only;SecureZIP 的 AES 格式另有 23001–23003。并非所有 .zip 都使用 17200。
KeePass
python keepass2john.py Master.kdbx
hashcat -a 0 -m 13400 keepass_hash "$WORDLIST"
移除提取结果的 Master: 标签,保留 ...。课程模式表包含 KeePass 1/2、AES/Twofish、带或不带 keyfile 的格式;课内例子不是“所有数据库都不需要密钥文件”。如果文件要求 keyfile,前置材料必须相应齐备。课程示例恢复 1qazzaq1,体现键盘路径字典的意义,耗时不能照抄作为保证。
python pdf2john.py inventory.pdf | awk -F':' '{print $2}'
hashcat -a 0 -m 10500 pdf_hash "$WORDLIST"
将首条命令提取的完整 ... 保存为 pdf_hash 后再运行第二条。该字段分隔处理仅针对此课内输出,不泛化为所有提取器。课程示例恢复 puppydog1。
PDF 格式 课程模式 1.1–1.3 10400,另列 10410/10420 碰撞变体 1.4–1.6 10500 1.7 Level 3 10600 1.7 Level 8 10700
验证要点:提取器成功解析、Hashcat 接受对应格式、恢复结果与练习材料对应。课程提及 SSH 私钥等其他文件,但未展开具体提取教程,不增写无来源命令。
13. WPA/WPA2 无线握手与 Hashcat
前置:已经取得授权范围内、包含有效验证材料的无线捕获文件,具有相应字典,并具备第 4 节 Hashcat 环境。本章以转换和离线恢复为重点,抓取过程不在这里补写;不启动无线攻击,也不把捕获文件传给在线服务。
13.1 四次握手:图中需要理解什么
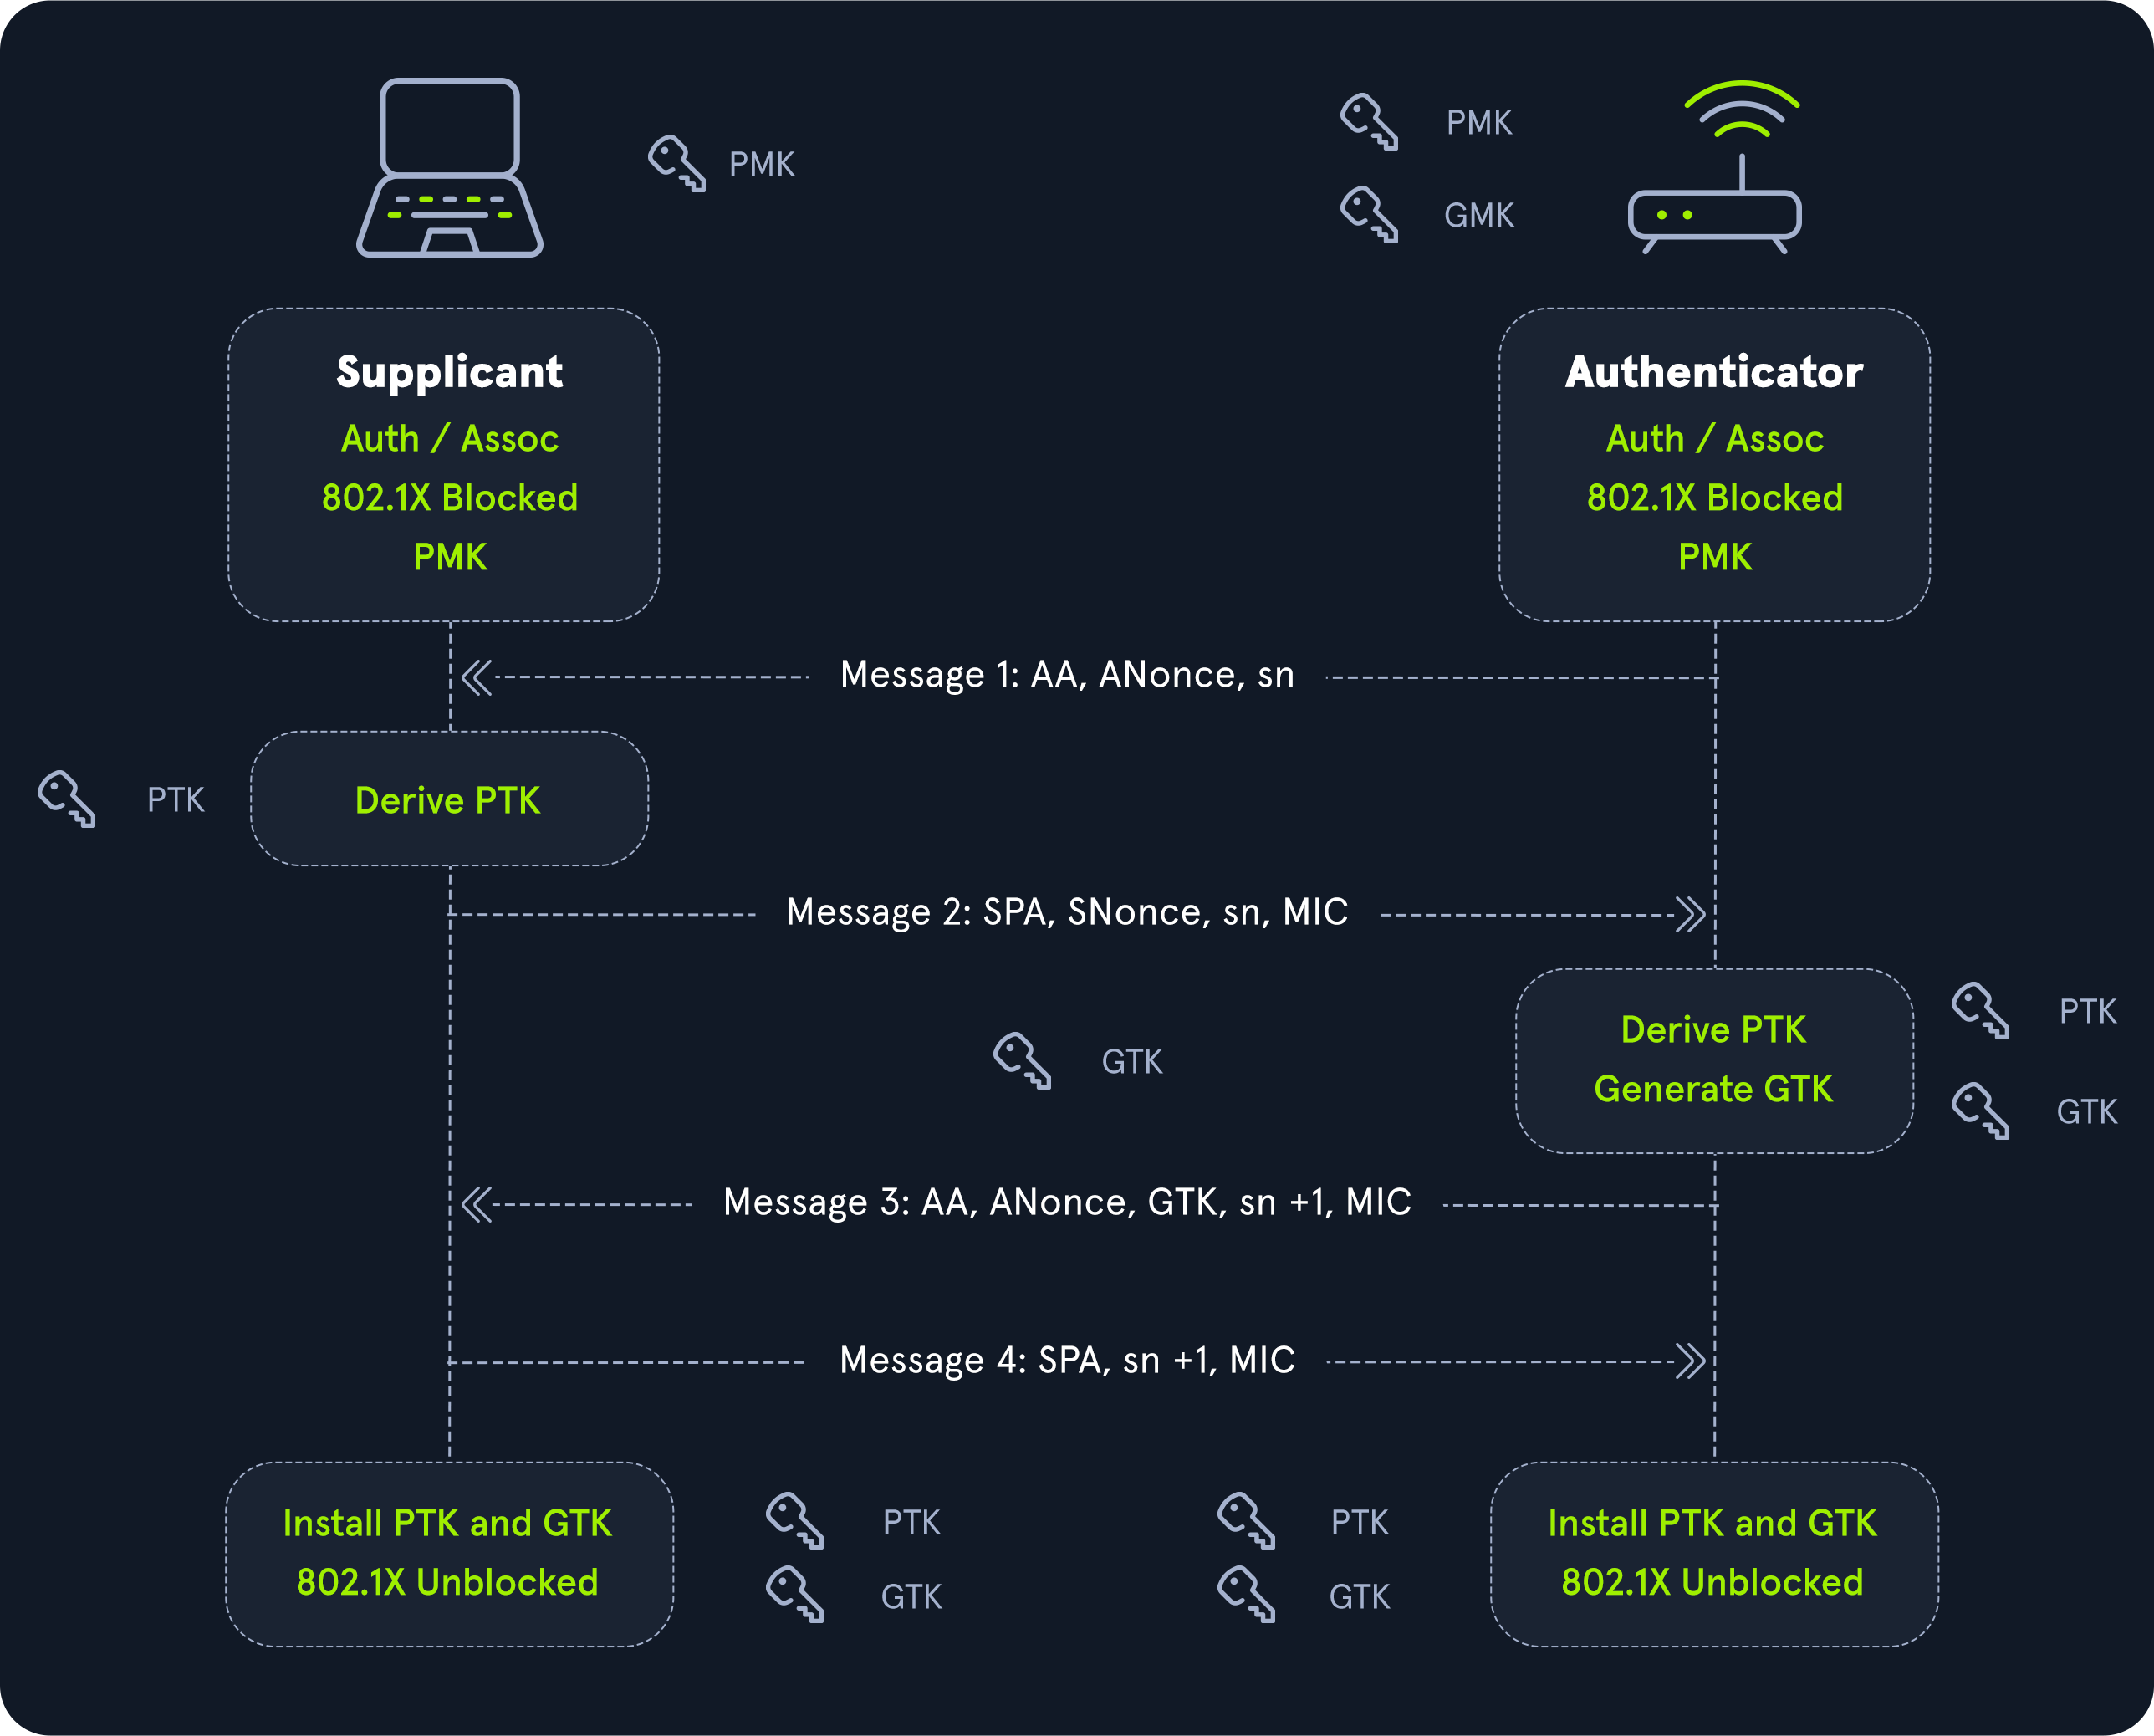
图左侧是客户端(Supplicant),右侧是 AP(Authenticator)。先完成认证/关联,随后进行四次消息交换:
- AP 向客户端提供 ANonce 等信息。
- 客户端派生 PTK,发回 SNonce 和 MIC。
- AP 派生 PTK 并提供 GTK 等信息,消息包含 MIC。
- 客户端确认,双方安装相关密钥,图中 802.1X 状态转为允许通信。
离线猜测利用捕获中的 nonce、地址、EAPOL/MIC 等验证材料判断候选是否正确。MIC 是完整性校验,不是“可直接读出的明文密码”;仅有任意无线流量不能保证可以破解。
13.2 旧转换方法:理解格式,不混用模式
课程先安装 hashcat-utils 并转换为历史 hccapx 格式:
git clone https://github.com/hashcat/hashcat-utils.git
cd hashcat-utils/src
make
./cap2hccapx.bin
./cap2hccapx.bin corp_capture1-01.cap mic_to_crack.hccapx
前置是 Git、Make 和可用编译环境;无参数运行查看用法,然后提供输入捕获与输出文件。示例写出 8 个握手材料,不代表任意捕获都包含有效握手。
格式兼容提醒:原页随后把 .hccapx 文件与 -m 22000 放在一起,又说明旧 2500 已弃用,存在新旧示例混用。不要仅改扩展名或模式编号就认为完成转换。下文用课程也已介绍的 hcxpcapngtool 重新生成 22000 对应输入,避免把旧二进制格式当新文本格式。
13.3 PMKID:另一种验证材料
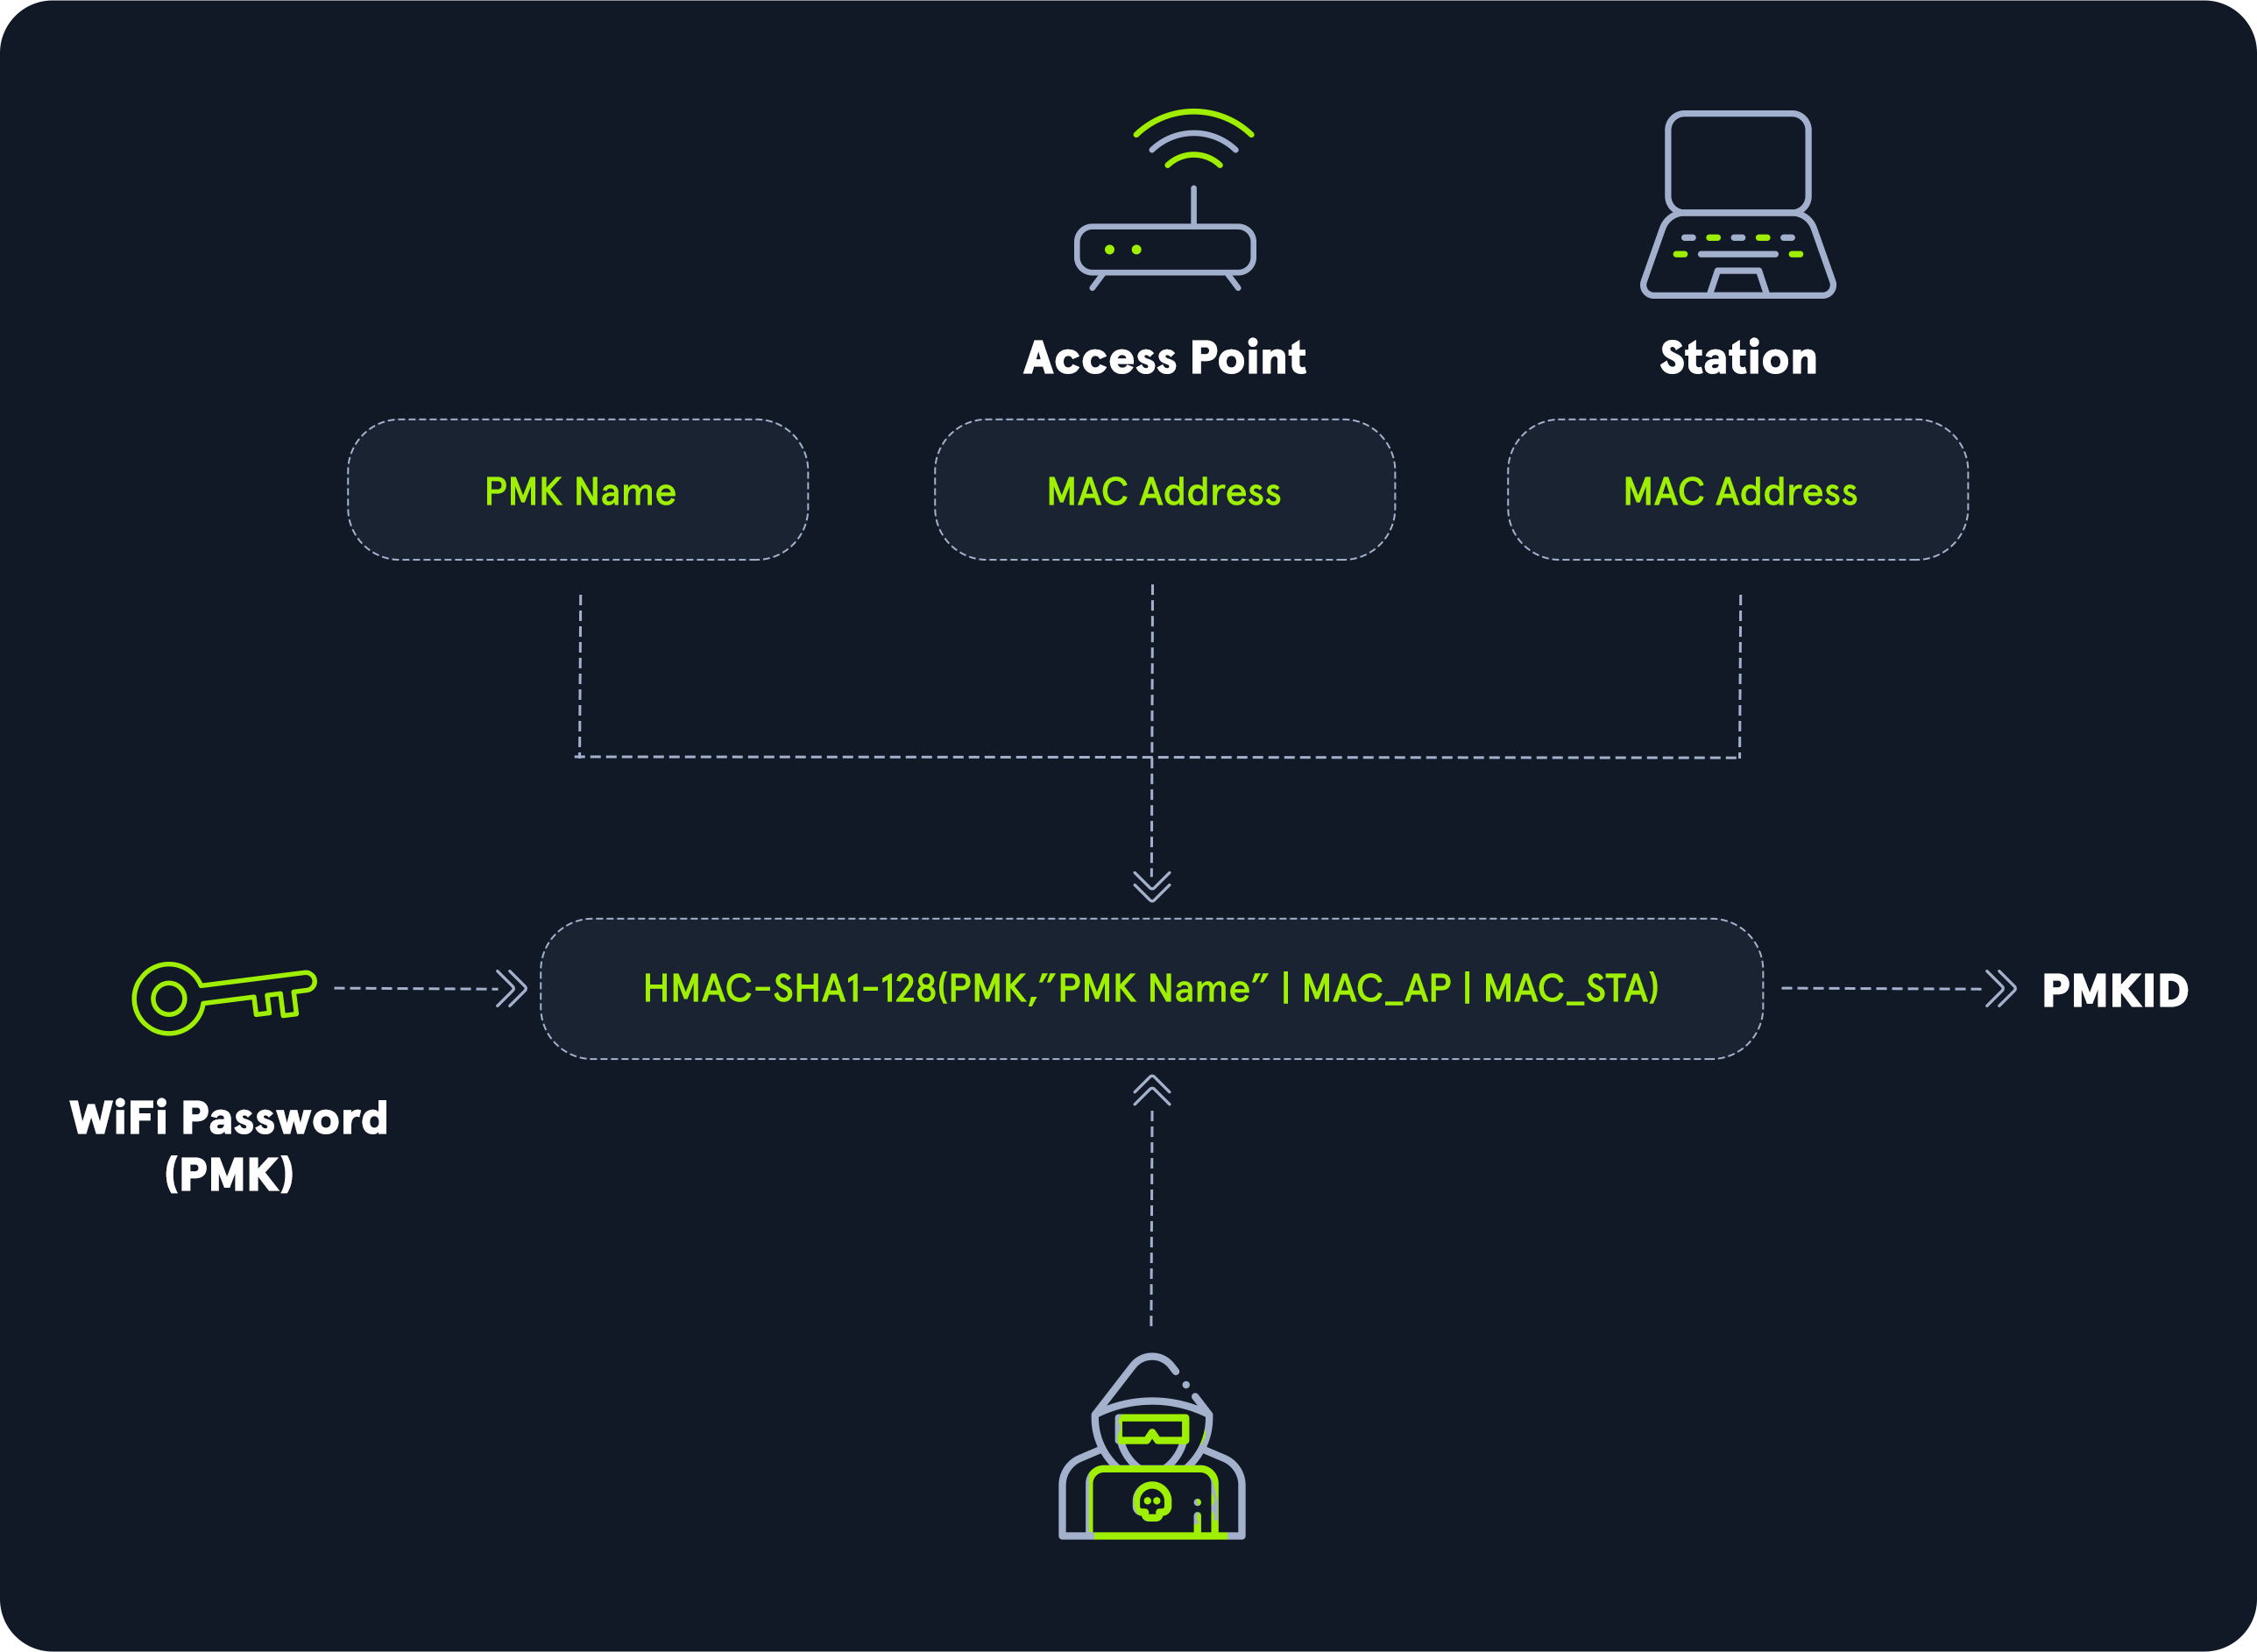
图中的计算关系为 HMAC-SHA1-128(PMK, "PMK Name" || MAC_AP || MAC_STA)。它将 PMK 与 AP/客户端地址联系起来,提供另一种候选验证途径。课程指出,在支持所述机制的 WPA/WPA2-PSK 场景下,不必以完整四次握手或使已有客户端断线作为同一前置条件;不能推导为任意 AP 都会提供可用 PMKID。
图对“WiFi Password (PMK)”的标注较简化;不要把图中文字直接理解为 PMK 就是可读的 Wi-Fi 明文密码。本章不另展开未给出的密钥派生实现。
13.4 hcxtools 首次准备与统一转换流程
课程给出的包管理器安装:
sudo apt install hcxtools
hcxpcapngtool -h
hcxpcapngtool cracking_pmkid.cap -o pmkidhash_corp
hashcat -a 0 -m 22000 pmkidhash_corp "$WORDLIST"
-o 输出 22000 可用哈希文件。原页帮助输出已说明这一点,并展示转换时产生 PMKID/EAPOL 材料;转换成功后才交给 Hashcat。文件名可保留课程名字,但文件内容必须是实际转换得到的新格式,而不是把原页旧四字段哈希文本照抄进去。
课程链接的 hcxtools README说明以 Linux 为环境,源码安装可 git clone、进入目录、make,再由具有安装权限的用户 make install;要求匹配相应编译依赖,当前源码要求与课程旧版本不同,不假定裸编译能在任意系统成功。包安装不是获取握手的过程,hcxtools 本身也不是负责破解 PSK 的工具。
验证顺序:查看转换工具报告是否提取有效材料 → 确认 Hashcat 接受格式 → 查看恢复结果。官方相关文档推荐 22000/22001 而非已弃用的 2500/16800 系列;旧 hcxpcaptool -z 仅作为课程历史方法,不与新流程混写。
原页有一次字典路径写为 .tar.gz;这里统一使用第 4 节的纯文本 rockyou.txt,不把归档包当作已经准备好的逐行字典。课程演示恢复值只是已知实验结果,不用作技能评估答案。在线转换服务意味着上传捕获材料,本笔记不执行此操作。
14. 技能评估:整合方法,而非抄答案
场景是协助同事完成 Inlanefreight 的授权评估:逐次恢复不同材料中的密码,为后续步骤提供条件。该节没有正文教学图片,不把页面的 Pwnbox 启动区域当教学截图。
阶段 提供的材料/背景 应用本章方法 SQL 注入后 未标注类型的哈希 先按格式、来源识别;对照示例哈希再选择模式 已进入内网 Responder 获得的 NetNTLMv2,所述 Relay 未成功 使用完整响应材料和对应模式,先字典再有针对性扩展 Kerberoasting 后 etype 23 的 TGS;账号在一台服务器的本地管理员组 确认票据前缀/类型,结合规则、字典、掩码调整候选 服务器材料 10240#backup_admin#... 保留用户名及格式,采用 DCC2 模式;预期成本较高 域级材料 NTDS 中多条用户密码哈希 批量恢复并分析密码复用;题目要求统计重复出现五次的明文
这里保留材料类型和决策顺序,不复制数千字符票据,也不提供答案。原页对系统材料获取位置的叙述是场景概述,不将其当作 SAM/DCC2 的完整取证指南。
可按下列检查表完成自己的练习:
- 每份输入单独保存,记录完整格式与来源,不把不同模式混入同一任务。
- 检查模式与格式,先测试高概率字典。
- 根据已知政策或恢复出的词形选择组合、混合、掩码和规则。
- 对慢速材料先缩小候选范围,比较进度与成本,不无限增加随机规则。
- 汇总恢复结果并按题意统计;确保“出现次数”统计的是目标明文,不是候选生成次数。
课程提示可以通过多种字典和方法挑战该 NTDS 练习的 100% 恢复,但这不是现实中所有哈希可破解的保证。Hashcat 安装、环境和首次参数选择回看第 4 节;相关 Responder/票据/数据库获取步骤本章未展开,不自行添加教程。
复习与交付说明
关键自检:-m 与 -a 是否分清?候选的前后位置是否正确?规则预览是否生成目标词形?盐、用户名、版本字段是否保留?文件提取输出是否已转成 Hashcat 要求的输入?旧无线格式是否误配新模式?
本章共 14 节,逐节核查正文和教学视觉内容,保留第 13 节两张必要原理图;其他节的终端演示是网页文本代码块,已归纳成命令与结果判断,不制造不存在的截图。安装及实例均未在本次运行验证;报告只验证笔记结构、覆盖记录和图片链接,不保证任意硬件/软件版本命令兼容。旧的一节未完成草稿保留作为历史文件,以本整章文件为准。