
模块共 19 小节。本文按“概念—适用场景—前置条件—具体操作—结果分析—注意事项”重新整理,不照搬课程原文。命令中的域名和地址仅为课程示例,请只在获得授权的环境中使用。
1. 介绍:Web 侦察的目标与类型
Web Reconnaissance 是信息收集阶段的重要组成部分,核心目标有四个:
- 识别资产:域名、子域名、IP、网页及采用的技术。
- 发现隐藏信息:备份、配置、内部文档、旧页面及未链接资源。
- 分析攻击面:梳理技术、配置、暴露入口与潜在薄弱点。
- 形成情报:把人员、邮箱、技术栈和行为规律关联起来,为后续评估提供方向。
主动侦察与被动侦察
类型 是否直接接触目标 常见技术 检测风险 主动侦察 是 端口扫描、漏洞扫描、服务枚举、Banner 获取、OS 指纹、网页爬取 低到高,取决于请求频率和载荷 被动侦察 否或极少 搜索引擎、WHOIS、公共 DNS、Web 存档、社交媒体、公开代码库 通常很低
主动侦察信息更直接、更全面,但容易留下日志或触发 IDS/WAF;被动侦察更隐蔽,但受公开数据完整性和时效性限制。完整流程通常先被动、再主动,并持续将新线索投入下一轮。
2. WHOIS
WHOIS 是用于查询域名、IP 地址块和自治系统注册信息的查询/响应协议,可以理解为互联网资源的“登记簿”。
记录中常见字段
- 域名、注册商与注册局 ID。
- 注册、更新和到期时间。
- 注册人、管理联系人、技术联系人。
- 权威名称服务器与域名状态。
- 滥用举报邮箱、电话及 DNSSEC 状态。
对侦察的价值
- 人员线索:联系人姓名、邮箱、电话可能揭示组织结构。
- 基础设施线索:注册商、名称服务器和地址反映 DNS/托管关系。
- 历史关系:历史记录可揭示所有权、联系人和技术配置的变化。
- 可信度判断:新注册、隐私隐藏、可疑 NS 或宽松注册商组合出现时,应提高警惕,但不能只凭单一指标下结论。
隐私保护与 GDPR 使许多现代 WHOIS 记录隐藏个人字段,因此 WHOIS 应与 DNS、证书和历史数据结合。
3. 使用 WHOIS
首次安装
sudo apt update
sudo apt install whois -y
基础查询
whois inlanefreight.com
whois facebook.com
分析顺序
- 检查创建、更新和到期时间,判断域名年龄和近期变化。
- 确认注册商与注册组织。
- 查看域名状态,例如是否禁止转移、更新或删除。
- 记录 NS,并在 DNS 阶段继续查询。
- 将联系人、滥用邮箱和组织名作为线索,不把它们直接视为可利用信息。
三种课程场景
- 钓鱼调查:结合“刚注册、联系人隐藏、可疑 NS/托管商”等信号判断风险。
- 恶意软件分析:查询 C2 域名的注册者、注册商和基础设施关系。
- 威胁情报:比较多个域名的注册时间、别名、共享 NS 和历史处置模式,提炼 TTP 与 IOC。
4. DNS 基础
DNS 将人类可读域名转换为 IP 地址。典型递归解析链路为:
- 客户端检查本地缓存。
- 递归解析器检查缓存;未命中则询问根服务器。
- 根服务器指向对应 TLD 服务器。
- TLD 服务器指向该域的权威名称服务器。
- 权威服务器返回记录,解析器缓存并回传给客户端。
hosts 文件
hosts 文件提供本地静态解析,会绕过普通 DNS 查询:
- Windows:C:\Windows\System32\drivers\etc\hosts
- Linux/macOS:/etc/hosts
格式:
<IP地址> <主机名> [别名 ...]
示例:
127. 0.0.1       localhost
192. 168.1.10    devserver.local
课程中的用途包括本地开发、连接测试及将域名映射到指定测试服务器。编辑需要管理员/root 权限,保存后通常立即生效。
区域文件和常见记录
$TTL 3600
@       IN SOA ns1.example.com. admin.example.com. (
          2024060401 3600 900 604800 86400 )
@       IN NS    ns1.example.com.
@       IN MX 10 mail.example.com.
www     IN A     192.0.2.1
mail    IN A     198.51.100.1
ftp     IN CNAME www.example.com.
记录 含义 侦察价值 A / AAAA 主机到 IPv4/IPv6 识别主机地址与共享基础设施 CNAME 主机别名 发现第三方服务、旧系统或间接依赖 MX 邮件交换器 确认邮件入口及提供商 NS 权威名称服务器 确认 DNS 托管与区域传送目标 TXT 任意文本 SPF、域验证、第三方产品线索 SOA 区域管理信息 主 NS、负责人、序列号和刷新策略 SRV 服务主机与端口 定位 SIP 等指定服务 PTR IP 到主机名 反向解析和地址归属线索
5. 使用 dig 挖掘 DNS
工具选择
工具 适合场景 dig 详细手工查询、指定服务器、追踪解析、区域传送 nslookup 基础 A/AAAA/MX 查询 host 快速、简洁地检查解析结果 dnsenum 自动记录枚举、字典枚举、区域传送与反查 fierce 递归发现及通配符检测 dnsrecon 综合 DNS 侦察与多种输出格式 theHarvester 从多种公开来源收集域、邮箱和人员线索
常用 dig 命令
dig domain.com
dig domain.com A
dig domain.com AAAA
dig domain.com MX
dig domain.com NS
dig domain.com TXT
dig domain.com CNAME
dig domain.com SOA
dig @1.1.1.1 domain.com
dig +trace domain.com
dig -x 192.168.1.1
dig +short domain.com
dig +noall +answer domain.com
dig domain.com ANY
ANY 查询可能被服务器忽略或限制,不能代替逐类型查询。
读懂标准输出
dig google.com
重点查看:
- status:如 NOERROR、NXDOMAIN。
- 标志:qr 表示响应,rd 表示请求递归,ad 表示解析器认为数据已验证。
- QUESTION:实际询问的名称和记录类型。
- ANSWER:答案、TTL、记录类型和值。
- SERVER:谁回答了请求,以及使用 UDP/TCP。
- Query time:响应时间。
只要简洁地址列表时:
dig +short hackthebox.com
大量 DNS 查询可能触发限速或监控,应控制速率并确认授权。
6. 子域名
子域名用于分隔博客、商店、邮件、开发、测试和管理等功能。它们可能暴露:
- 安全措施较宽松的开发/预发布环境。
- 未在主站链接的登录或管理入口。
- 被遗忘的旧应用和过时组件。
- 配置、文档及其他敏感资源。
两类发现方式
- 主动枚举:区域传送、DNS 字典/暴力枚举;结果可控但更容易被检测。
- 被动枚举:证书透明度日志、搜索引擎和聚合数据库;更隐蔽,但可能不完整。
有效结果应至少满足:名称能解析,或由证书/历史记录等可靠来源支持。解析成功后还需验证对应 Web 服务是否真正存在。
7. 子域名暴力枚举
工作流程
- 选择词表:通用、行业/技术定向,或根据已有命名规律定制。
- 将候选词附加到主域名。
- 查询 A/AAAA 等记录。
- 过滤解析成功的名称。
- 对成功结果做 HTTP 或其他服务验证。
课程列出的工具包括 dnsenum、Fierce、DNSRecon、Amass、Assetfinder 和 PureDNS。
dnsenum 使用示例
前置条件:目标域名、SecLists 子域词表,以及明确的扫描授权。
dnsenum --enum inlanefreight.com \
  -f /usr/share/seclists/Discovery/DNS/subdomains-top1million-20000.txt \
  -r
参数含义:
- --enum:启用一组常见枚举选项。
- -f:指定词表。
- -r:对已发现子域继续递归枚举。
输出中先确认目标主域地址,再记录暴力枚举阶段出现的有效子域。递归会显著增加查询量。
8. DNS 区域传送
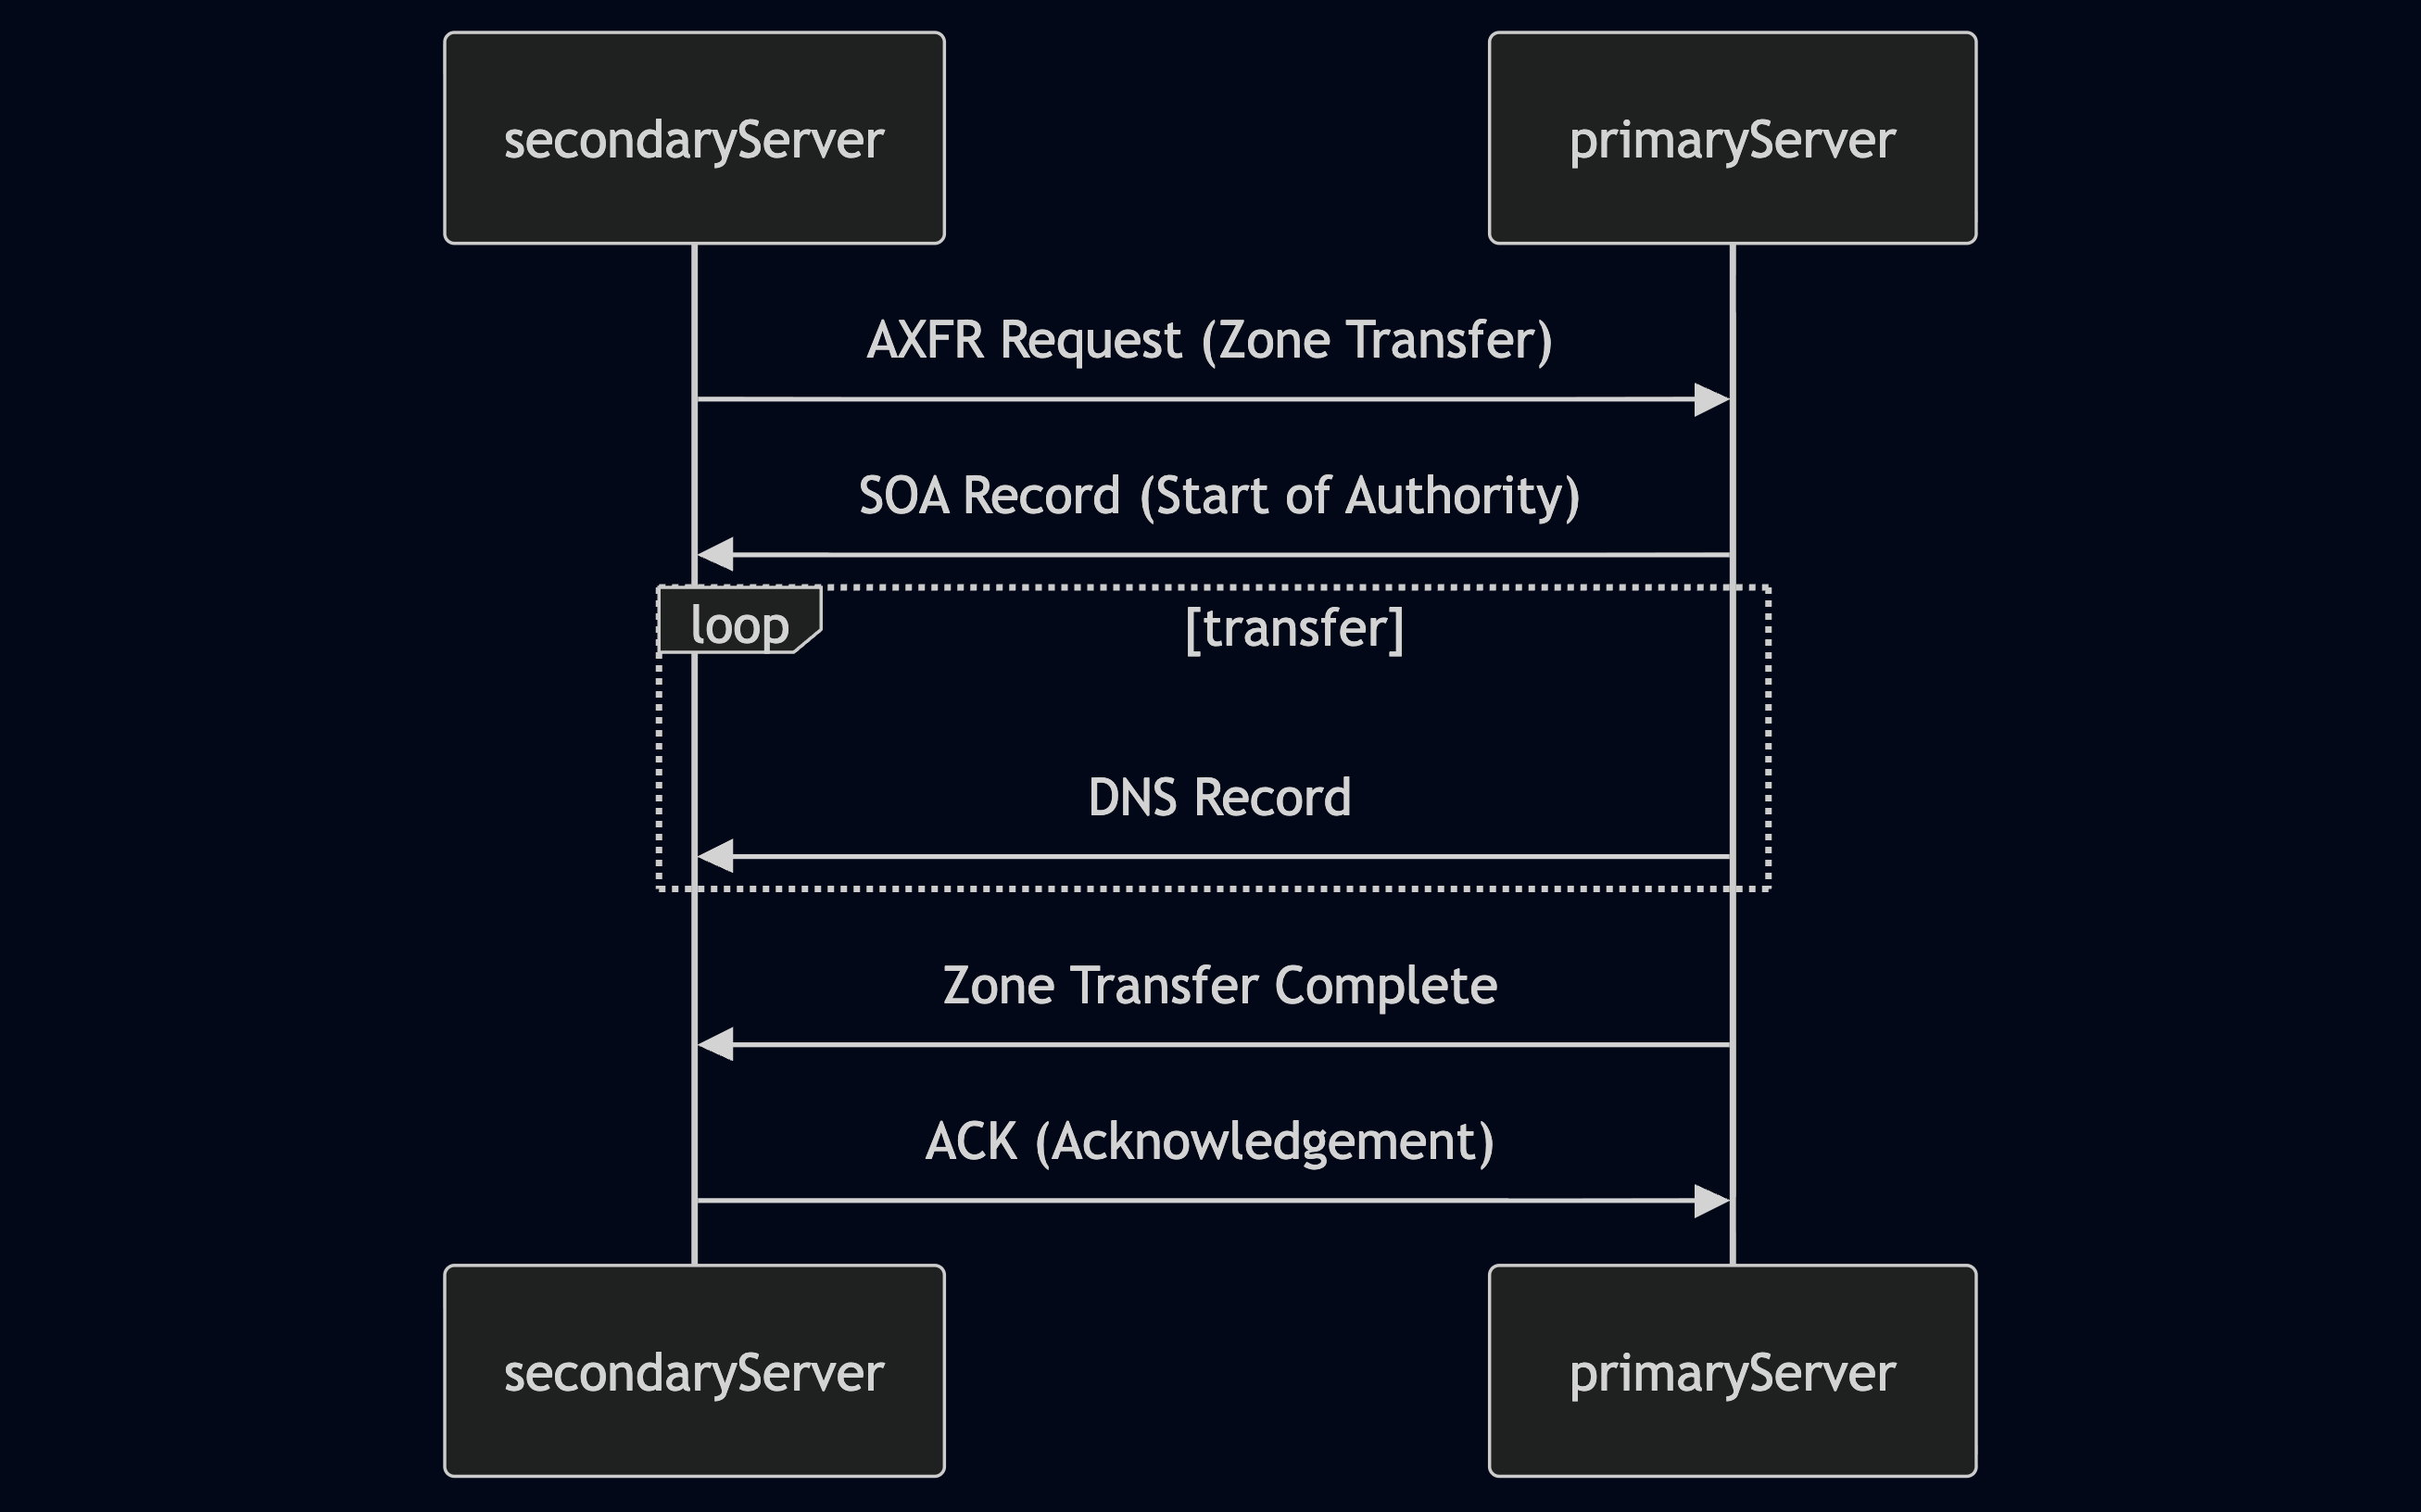
AXFR 用于在主、辅助 DNS 服务器之间复制整个区域。如果访问控制错误,外部查询者可能获得子域、IP、MX、NS、TXT、SRV 等完整记录。
操作示例
先通过 NS 记录确定权威服务器,再逐台尝试:
dig NS zonetransfer.me
dig axfr @nsztm1.digi.ninja zonetransfer.me
成功表现:输出以 SOA 开始和结束,中间包含大量区域记录,并显示 XFR size;失败通常返回拒绝或无传送数据。
风险与修复
成功的未授权 AXFR 会暴露网络结构和隐藏子域。服务端应只允许经过授权的辅助服务器传送区域。即使测试失败,也能说明服务器至少执行了传送访问控制;不得据此推断其整体 DNS 安全。
9. 虚拟主机(Virtual Hosts)
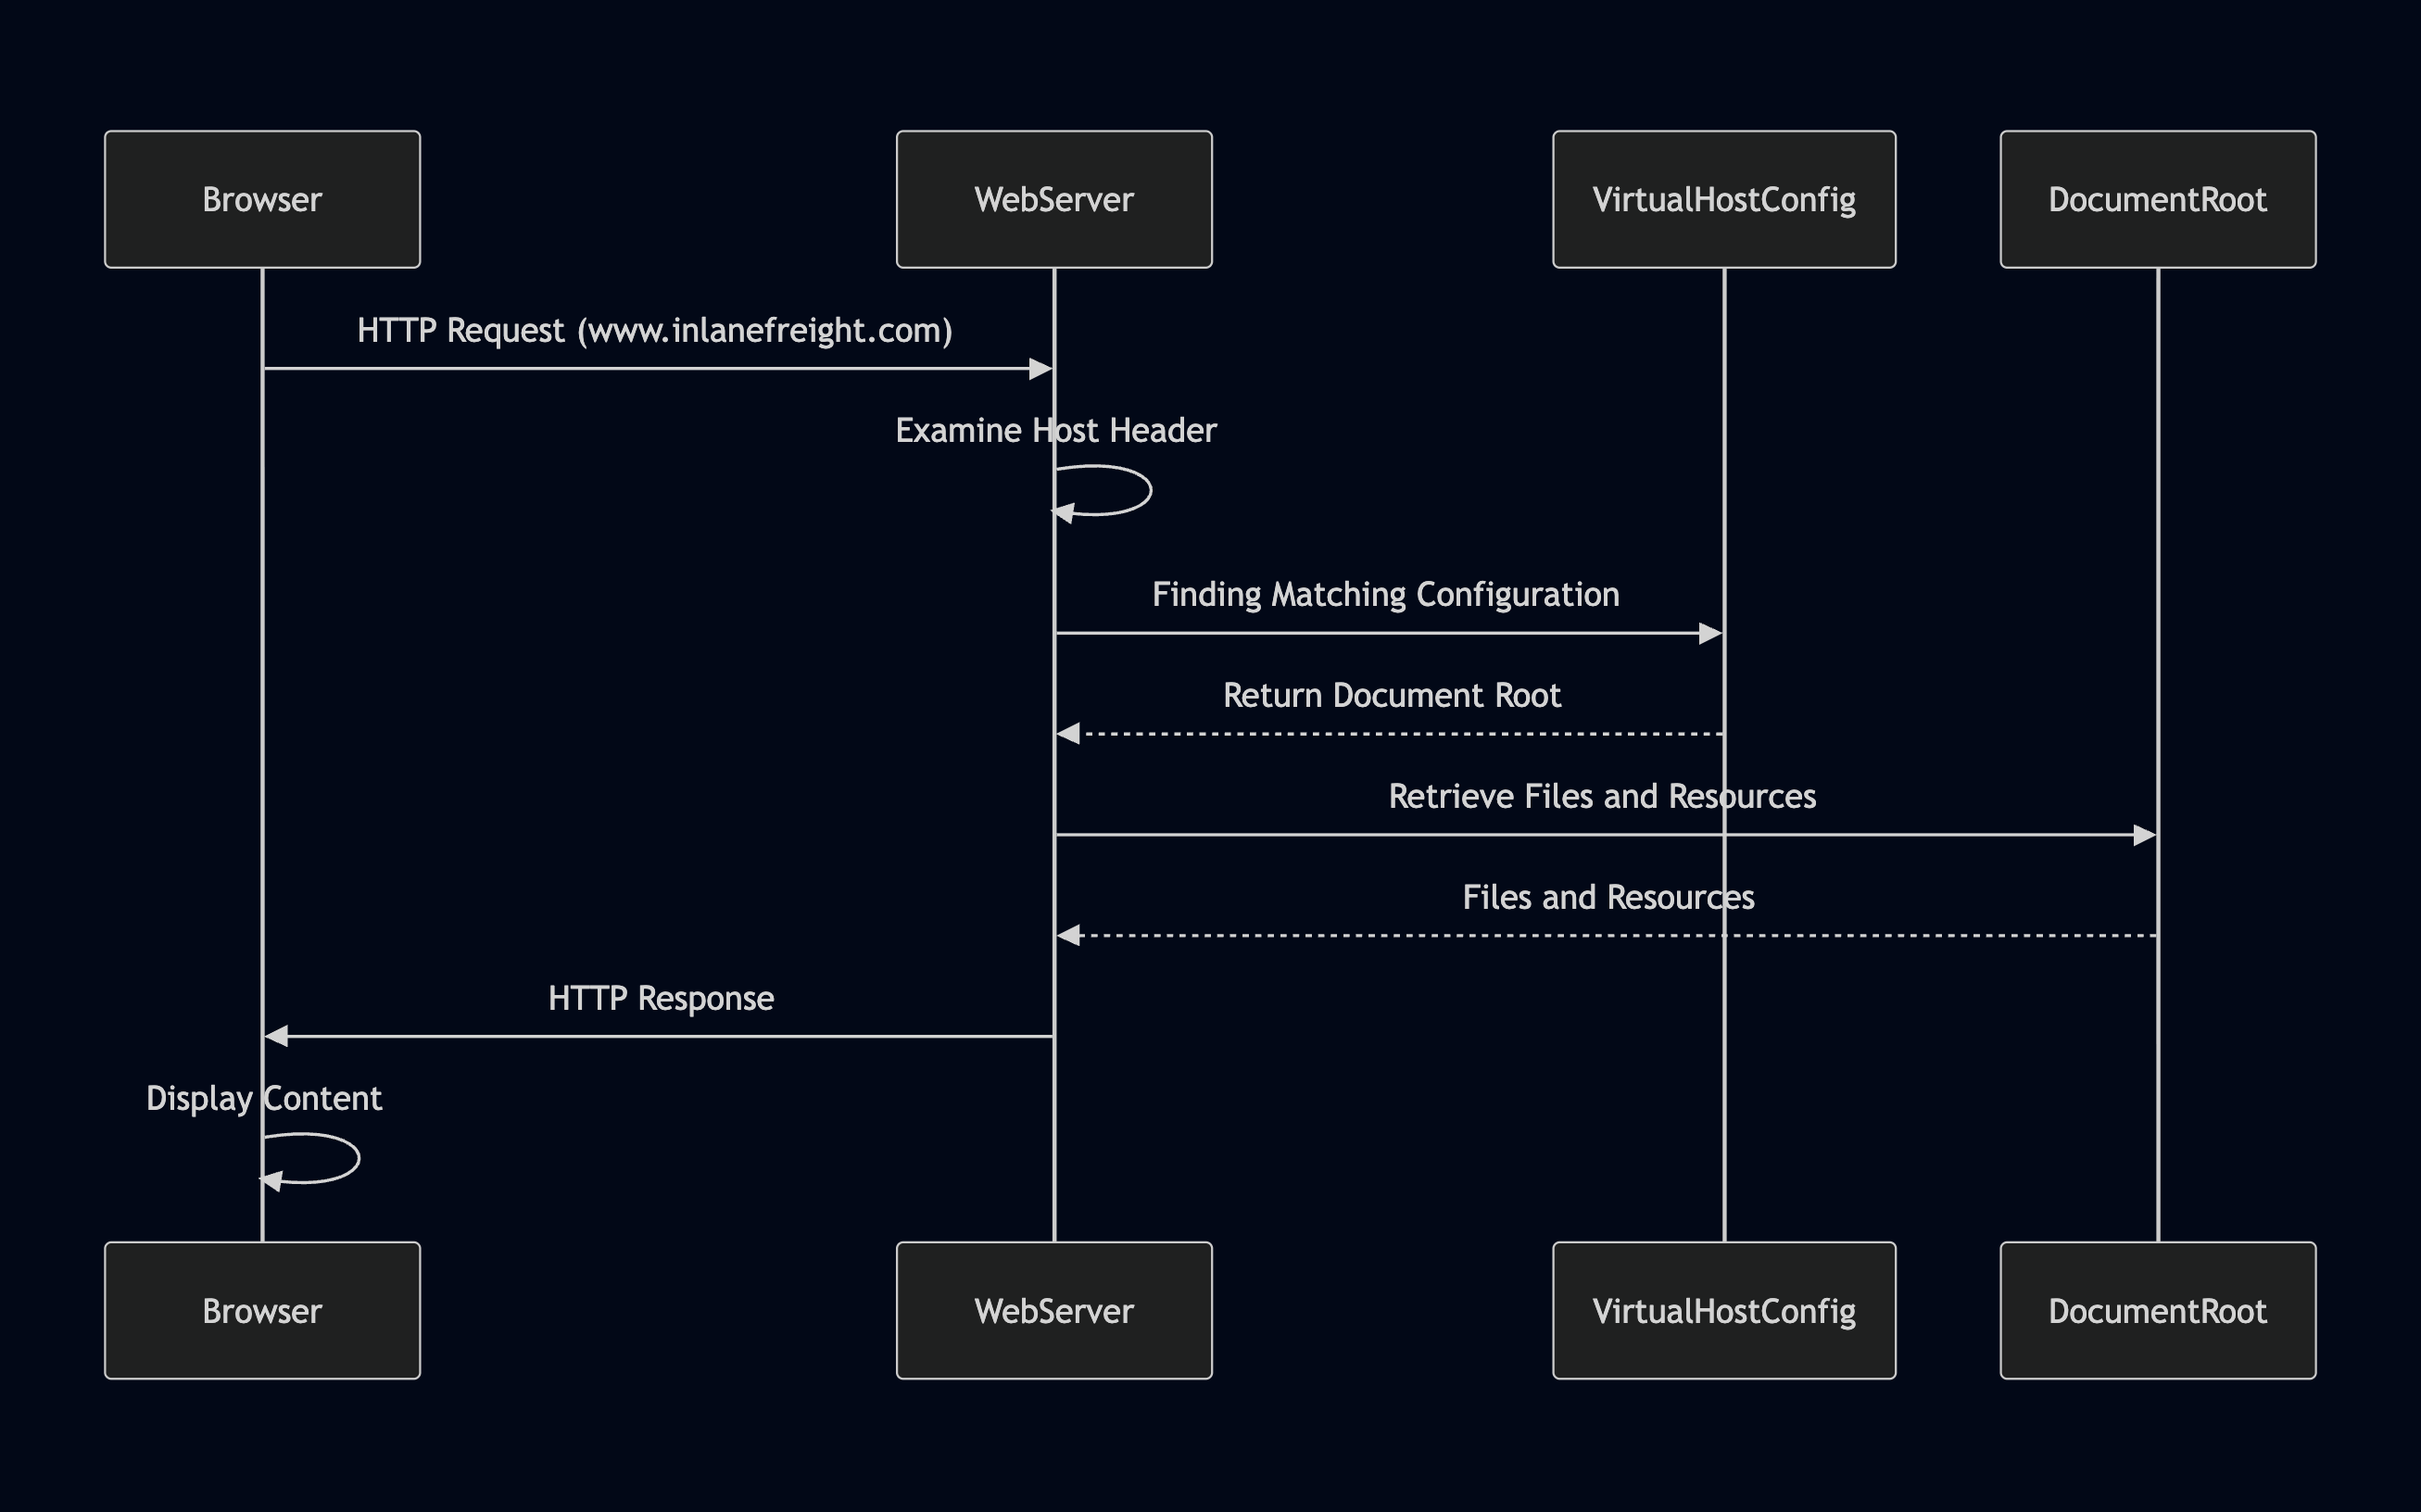
Web 服务器可以用一个 IP 托管多个站点。名称型虚拟主机根据 HTTP Host 请求头决定返回哪个站点,因此某个 VHost 即使没有公共 DNS 记录,也可能真实存在。
VHost 与子域的区别
- 子域属于 DNS 命名层,通常有 A/AAAA/CNAME 记录。
- VHost 属于 Web 服务器配置层,可对应子域、不同主域、IP 或端口。
- 未公开解析的 VHost 可以通过 hosts 文件将候选名称映射到已知 IP 后访问。
三种虚拟托管
- 基于名称:依赖 Host 头,最常见且节省地址。
- 基于 IP:每个站点使用不同地址,隔离较强但成本高。
- 基于端口:不同站点监听不同端口,URL 需显式带端口。
使用 Gobuster 枚举 VHost
前置条件:已知目标 IP/基础域名、Web 端口与词表;如果基础域无法解析,先加入 hosts 文件。
gobuster vhost \
  -u http://<目标IP或基础域名> \
  -w <词表> \
  --append-domain
课程示例:
gobuster vhost \
  -u http://inlanefreight.htb:81 \
  -w /usr/share/seclists/Discovery/DNS/subdomains-top1million-110000.txt \
  --append-domain
补充参数:-t 调整线程数,-k 忽略 TLS 证书错误,-o 保存输出。分析时比较状态码与响应大小,异常结果再手工加入 hosts 并访问确认。VHost 枚举会产生大量请求,可能触发 WAF/IDS。
10. 证书透明度日志
Certificate Transparency(CT)日志是公开、仅追加的 SSL/TLS 证书账本。它让证书签发行为可审计,也能用于发现证书 SAN 中的历史和当前子域。
为什么适合子域枚举
- 不依赖猜测或词表。
- 能发现难猜、已停用或只在旧证书出现的名称。
- 可帮助定位错误签发或可疑证书。
常用平台:crt.sh 提供轻量查询;Censys 提供更丰富的证书、主机和属性过滤。
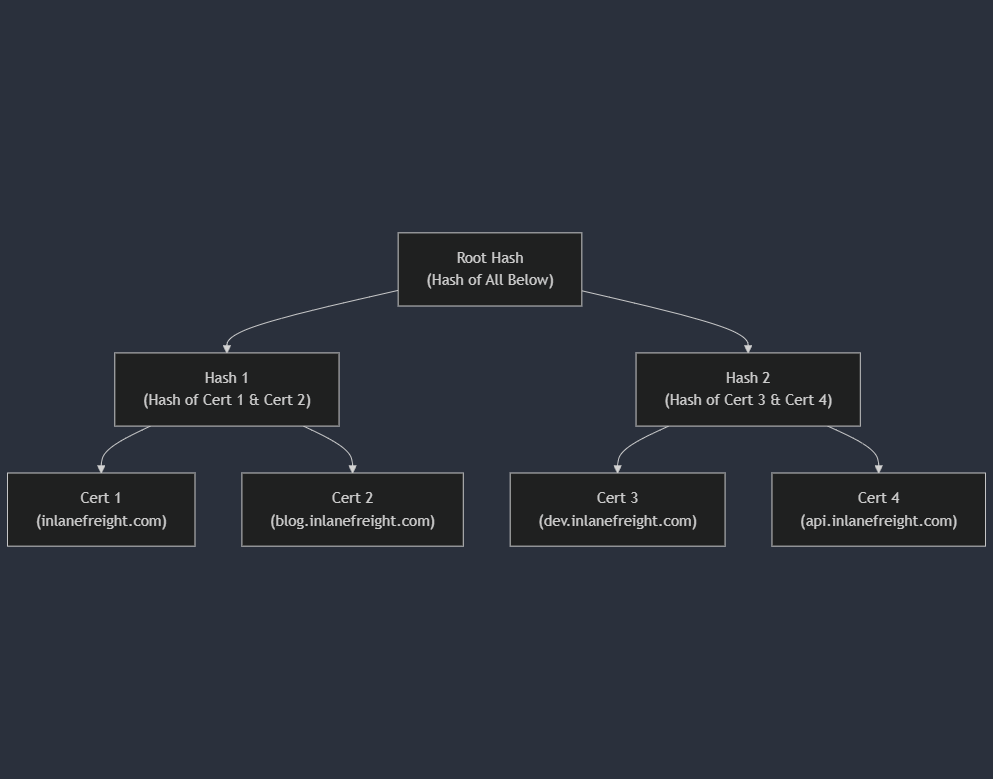
crt.sh API 查询
前置条件:curl、jq。
curl -s 'https://crt.sh/?q=facebook.com&output=json' \
  | jq -r '.[] | select(.name_value | contains("dev")) | .name_value' \
  | sort -u
流程是获取 JSON、筛选 name_value 中含 dev 的名称、原始输出字符串并去重。CT 记录不保证当前仍可解析,结果必须再次通过 DNS/HTTP 验证。
11. Web 技术指纹
指纹识别用于判断 Web 服务器、操作系统、框架、CMS、WAF 和组件版本,以便确定后续检查重点。常用信号包括 Banner、HTTP 头、特征响应、HTML/脚本结构和页面内容。
手工 Banner 与响应头
curl -I http://inlanefreight.com
curl -I https://inlanefreight.com
curl -I https://www.inlanefreight.com
不要只查第一跳。课程示例从连续重定向中依次发现:
- Server: Apache/2.4.41 (Ubuntu)。
- X-Redirect-By: WordPress。
- Link 中的 /wp-json/ API 路径。
Wafw00f:检测 WAF
首次安装:
pip3 install git+https://github.com/EnableSecurity/wafw00f
使用:
wafw00f inlanefreight.com
输出给出是否存在 WAF、可能产品和请求数量。确认 WAF 后应降低请求速率,并意识到其可能改变扫描响应。
Nikto:基础 Web 服务器检查
课程中的首次配置:
sudo apt update && sudo apt install -y perl
git clone https://github.com/sullo/nikto
cd nikto/program
chmod +x ./nikto.pl
运行示例:
./nikto.pl -h inlanefreight.com -Tuning b
课程结果展示了 IP、TLS 证书、服务器版本、WordPress、登录路径、缺失安全头和公开 license.txt 等线索。Nikto 结论包含推测和误报,应逐项手工验证;它会发送大量请求,检测风险明显高于 curl -I。
12. 爬取基础
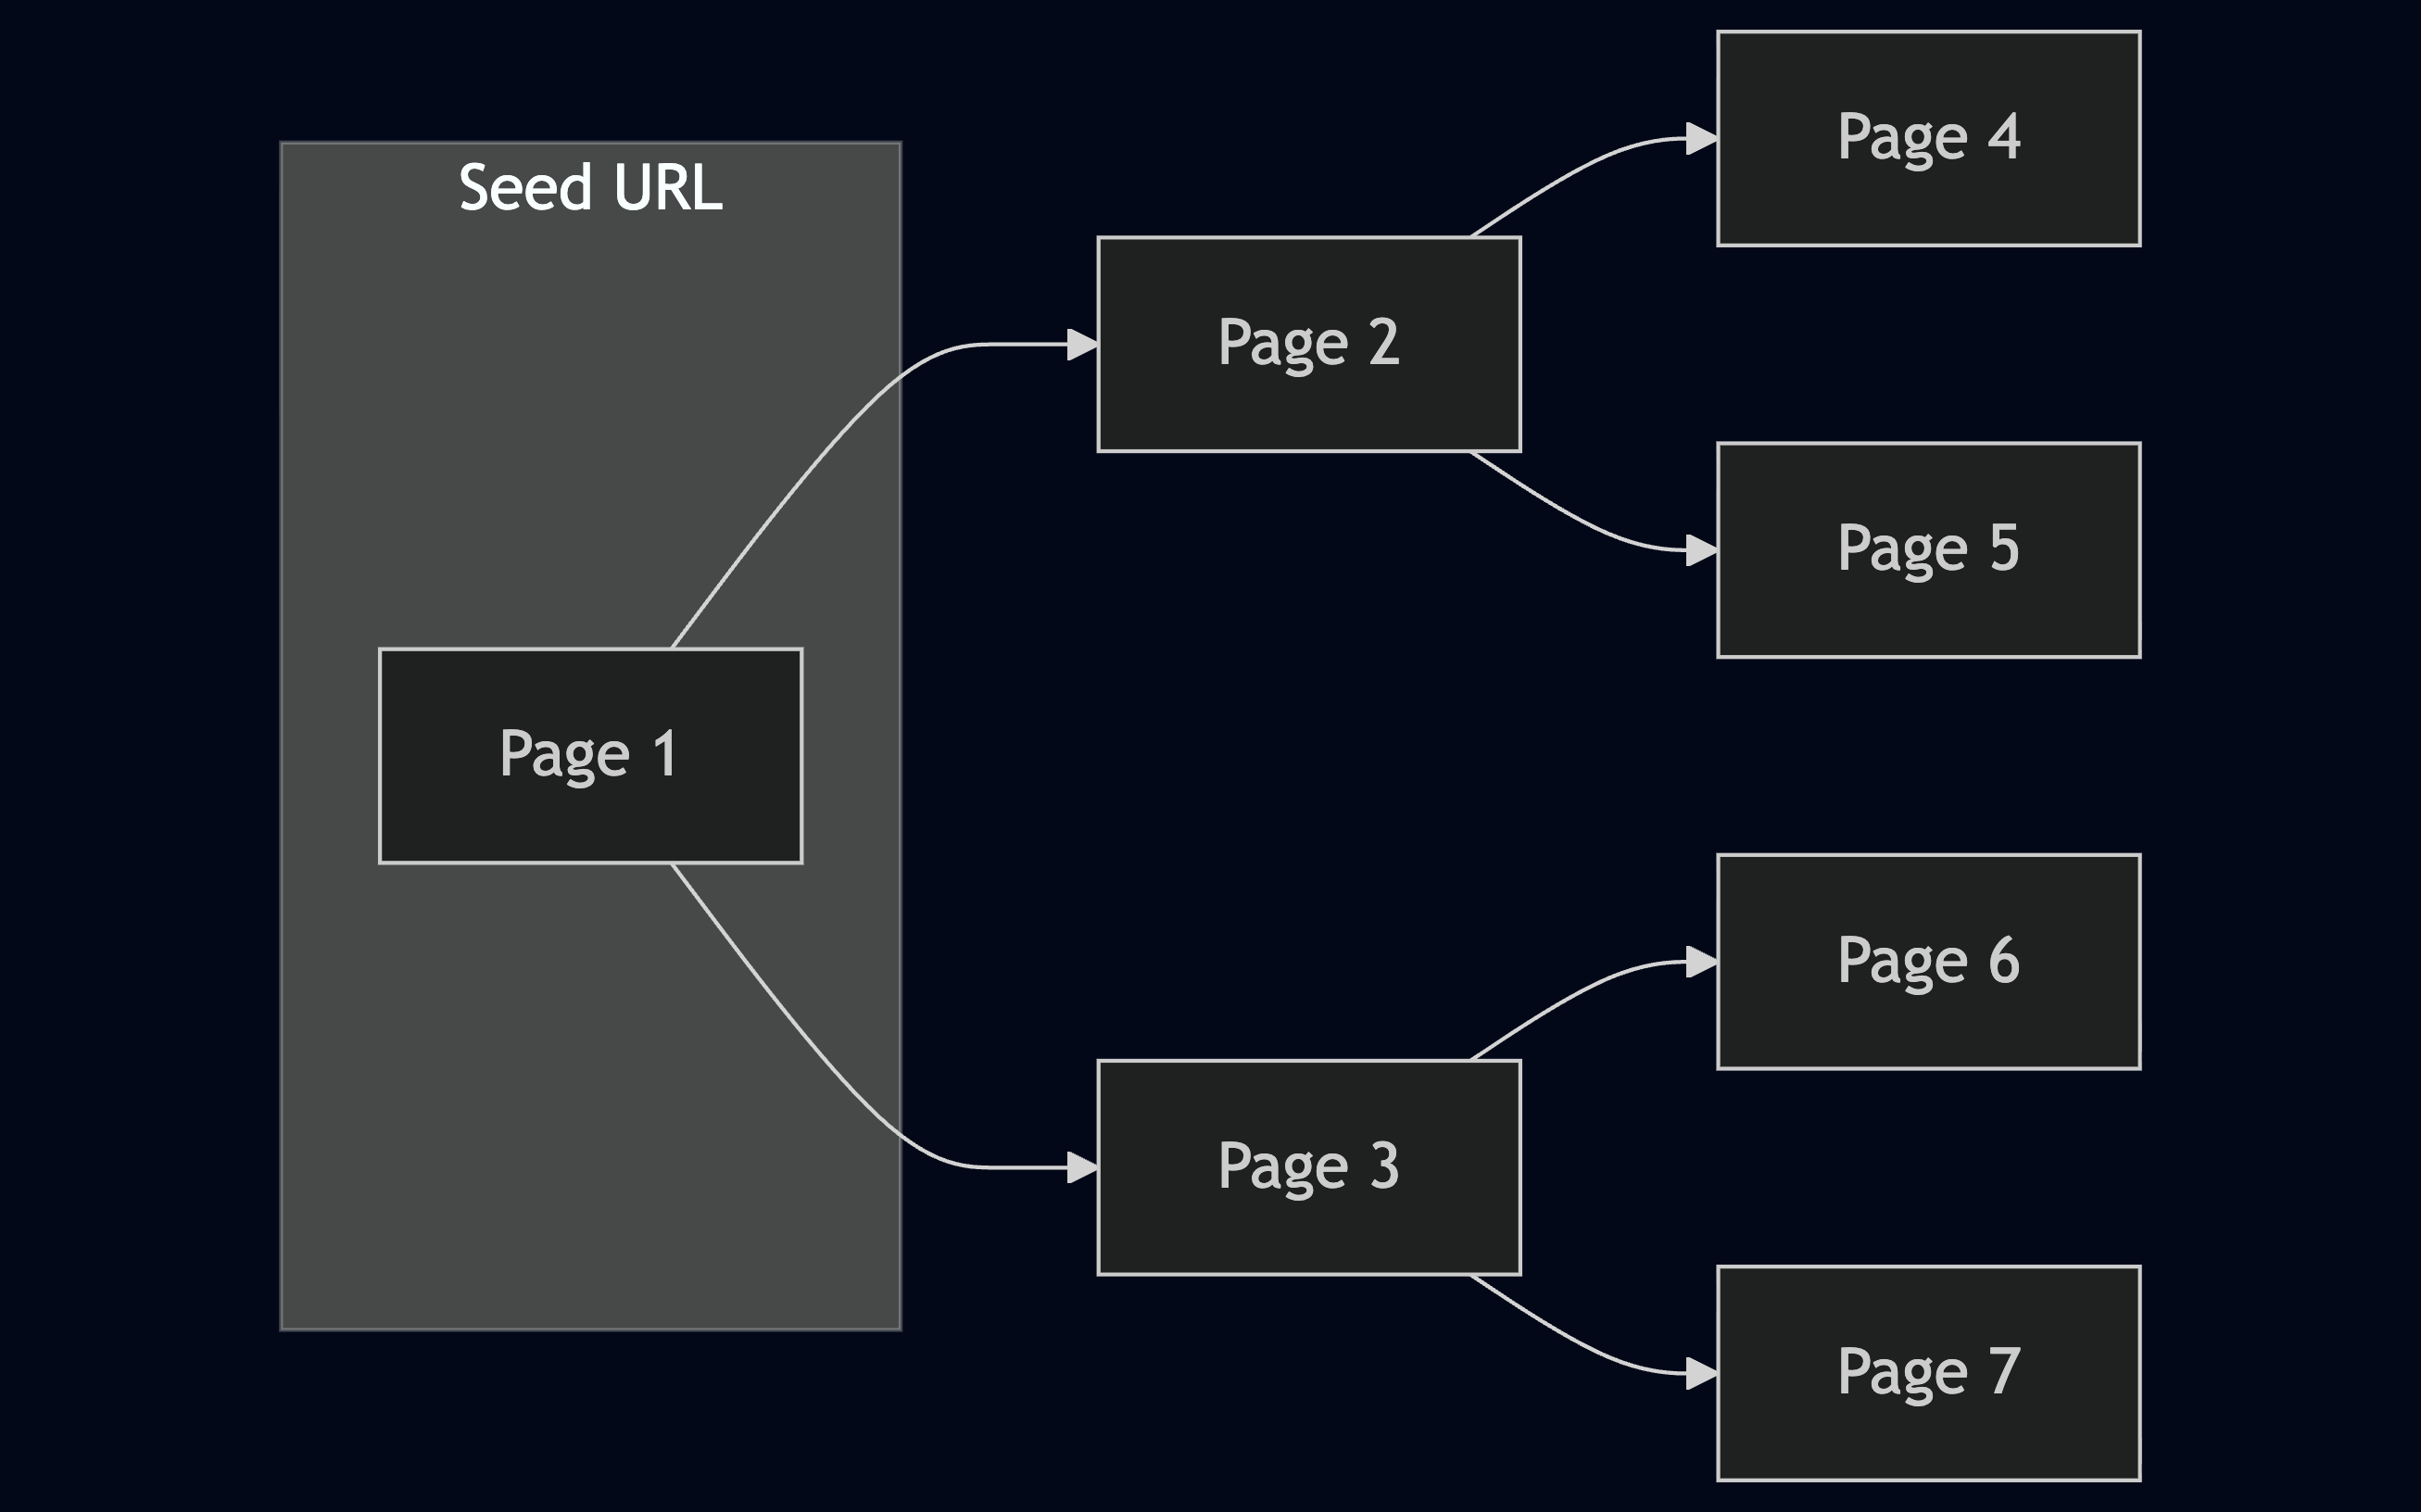
爬虫从种子 URL 开始,获取页面、解析链接、加入待访问队列,再重复执行。它跟随真实链接,与猜测路径的模糊测试不同。
两种策略
- 广度优先:先覆盖当前层所有链接,适合快速掌握整体结构。
- 深度优先:沿单一路径深入后再回溯,适合深入特定分支。
应提取的内容
- 内部与外部链接。
- HTML 注释和页面元数据。
- PDF 等外部文件。
- JavaScript、图片、音频和视频路径。
- 表单字段。
- 备份、配置和日志文件线索。
单条数据往往意义有限;要把目录名称、评论、软件版本和配置文件等线索关联。例如多个 URL 指向 /files/,应进一步确认是否开启目录浏览。
13. robots.txt
robots.txt 是位于网站根目录的纯文本爬虫指令文件,例如:
https://www.example.com/robots.txt
它不是访问控制机制,主要约束遵循 Robots Exclusion Standard 的合法爬虫。
常见指令
User-agent: *
Disallow: /admin/
Disallow: /private/
Allow: /public/

User-agent: Googlebot
Crawl-delay: 10

Sitemap: https://www.example.com/sitemap.xml
- User-agent:规则适用的爬虫,* 表示所有。
- Disallow:不应抓取的路径。
- Allow:在更宽泛的禁止规则中明确允许路径。
- Crawl-delay:请求间隔。
- Sitemap:站点地图位置。
侦察价值与注意事项
禁止路径可能暴露管理目录、私有内容、备份或蜜罐;Sitemap 可快速补齐页面结构。但 Disallow 不代表获得访问授权,仍应遵守测试范围、服务器限制和法律/伦理要求。
14. .well-known URI
RFC 8615 规定在站点根路径 /.well-known/ 集中发布标准化元数据,例如:
URI 用途 /.well-known/security.txt 漏洞报告联系人和政策 /.well-known/change-password 标准密码修改入口 /.well-known/openid-configuration OpenID Connect 提供者配置 /.well-known/assetlinks.json 域名与应用等数字资产关系验证 /.well-known/mta-sts.txt 邮件 MTA-STS 策略
OpenID Connect 示例
访问:
https://example.com/.well-known/openid-configuration
典型 JSON 会公开:issuer、授权端点、令牌端点、用户信息端点、jwks_uri、支持的 scope、响应类型和签名算法。这些内容用于绘制认证架构,不代表端点本身存在漏洞。
15. 爬虫工具与 ReconSpider
课程列出的常见爬虫:Burp Suite Spider、OWASP ZAP、Scrapy 和 Apache Nutch。无论使用哪一种,都应获得授权、控制请求频率并避免压垮服务器。
安装 Scrapy
pip3 install scrapy
下载并运行课程 ReconSpider
wget -O ReconSpider.zip \
  https://academy.hackthebox.com/storage/modules/144/ReconSpider.v1.2.zip
unzip ReconSpider.zip
python3 ReconSpider.py http://inlanefreight.com
将域名替换为获授权目标。运行后结果写入 results.json。
读取结果
JSON 字段包括:
- emails:邮箱。
- links:站内链接。
- external_files:PDF 等外部文件。
- js_files:JavaScript 资源。
- form_fields:表单字段。
- images、videos、audio:媒体资源。
- comments:HTML 注释。
优先从 JS、外部文件、注释和表单中寻找新端点、路径与技术线索,然后回到 DNS、指纹和手工验证环节。
16. 搜索引擎发现
搜索引擎可以被动发现已索引的页面、员工信息、敏感文档、登录入口和配置痕迹,但不能覆盖未被索引或刻意隐藏的内容。
常用操作符
操作符 用途 示例 site: 限定域名 site:example.com inurl: URL 含关键字 site:example.com inurl:login filetype: 限定文件类型 site:example.com filetype:pdf intitle: 标题含关键字 intitle:"confidential report" intext: 正文含关键字 intext:"password reset" cache: 查看缓存版本 cache:example.com related: 相似站点 related:example.com allintext: 正文包含全部词 allintext:admin password reset allinurl: URL 包含全部词 allinurl:admin panel AND / OR / NOT 组合和排除 site:example.com AND (inurl:admin OR inurl:login) "..." 精确短语 "information security policy" - 排除关键词 site:news.com -inurl:sports
课程中的 Google Dork 示例
site:example.com inurl:login
site:example.com (inurl:login OR inurl:admin)
site:example.com filetype:pdf
site:example.com (filetype:xls OR filetype:docx)
site:example.com inurl:config.php
site:example.com (ext:conf OR ext:cnf)
site:example.com inurl:backup
site:example.com filetype:sql
搜索结果中的敏感文件仍受授权和数据处理规则约束;“搜索得到”不等于允许下载或使用。
17. Web 存档
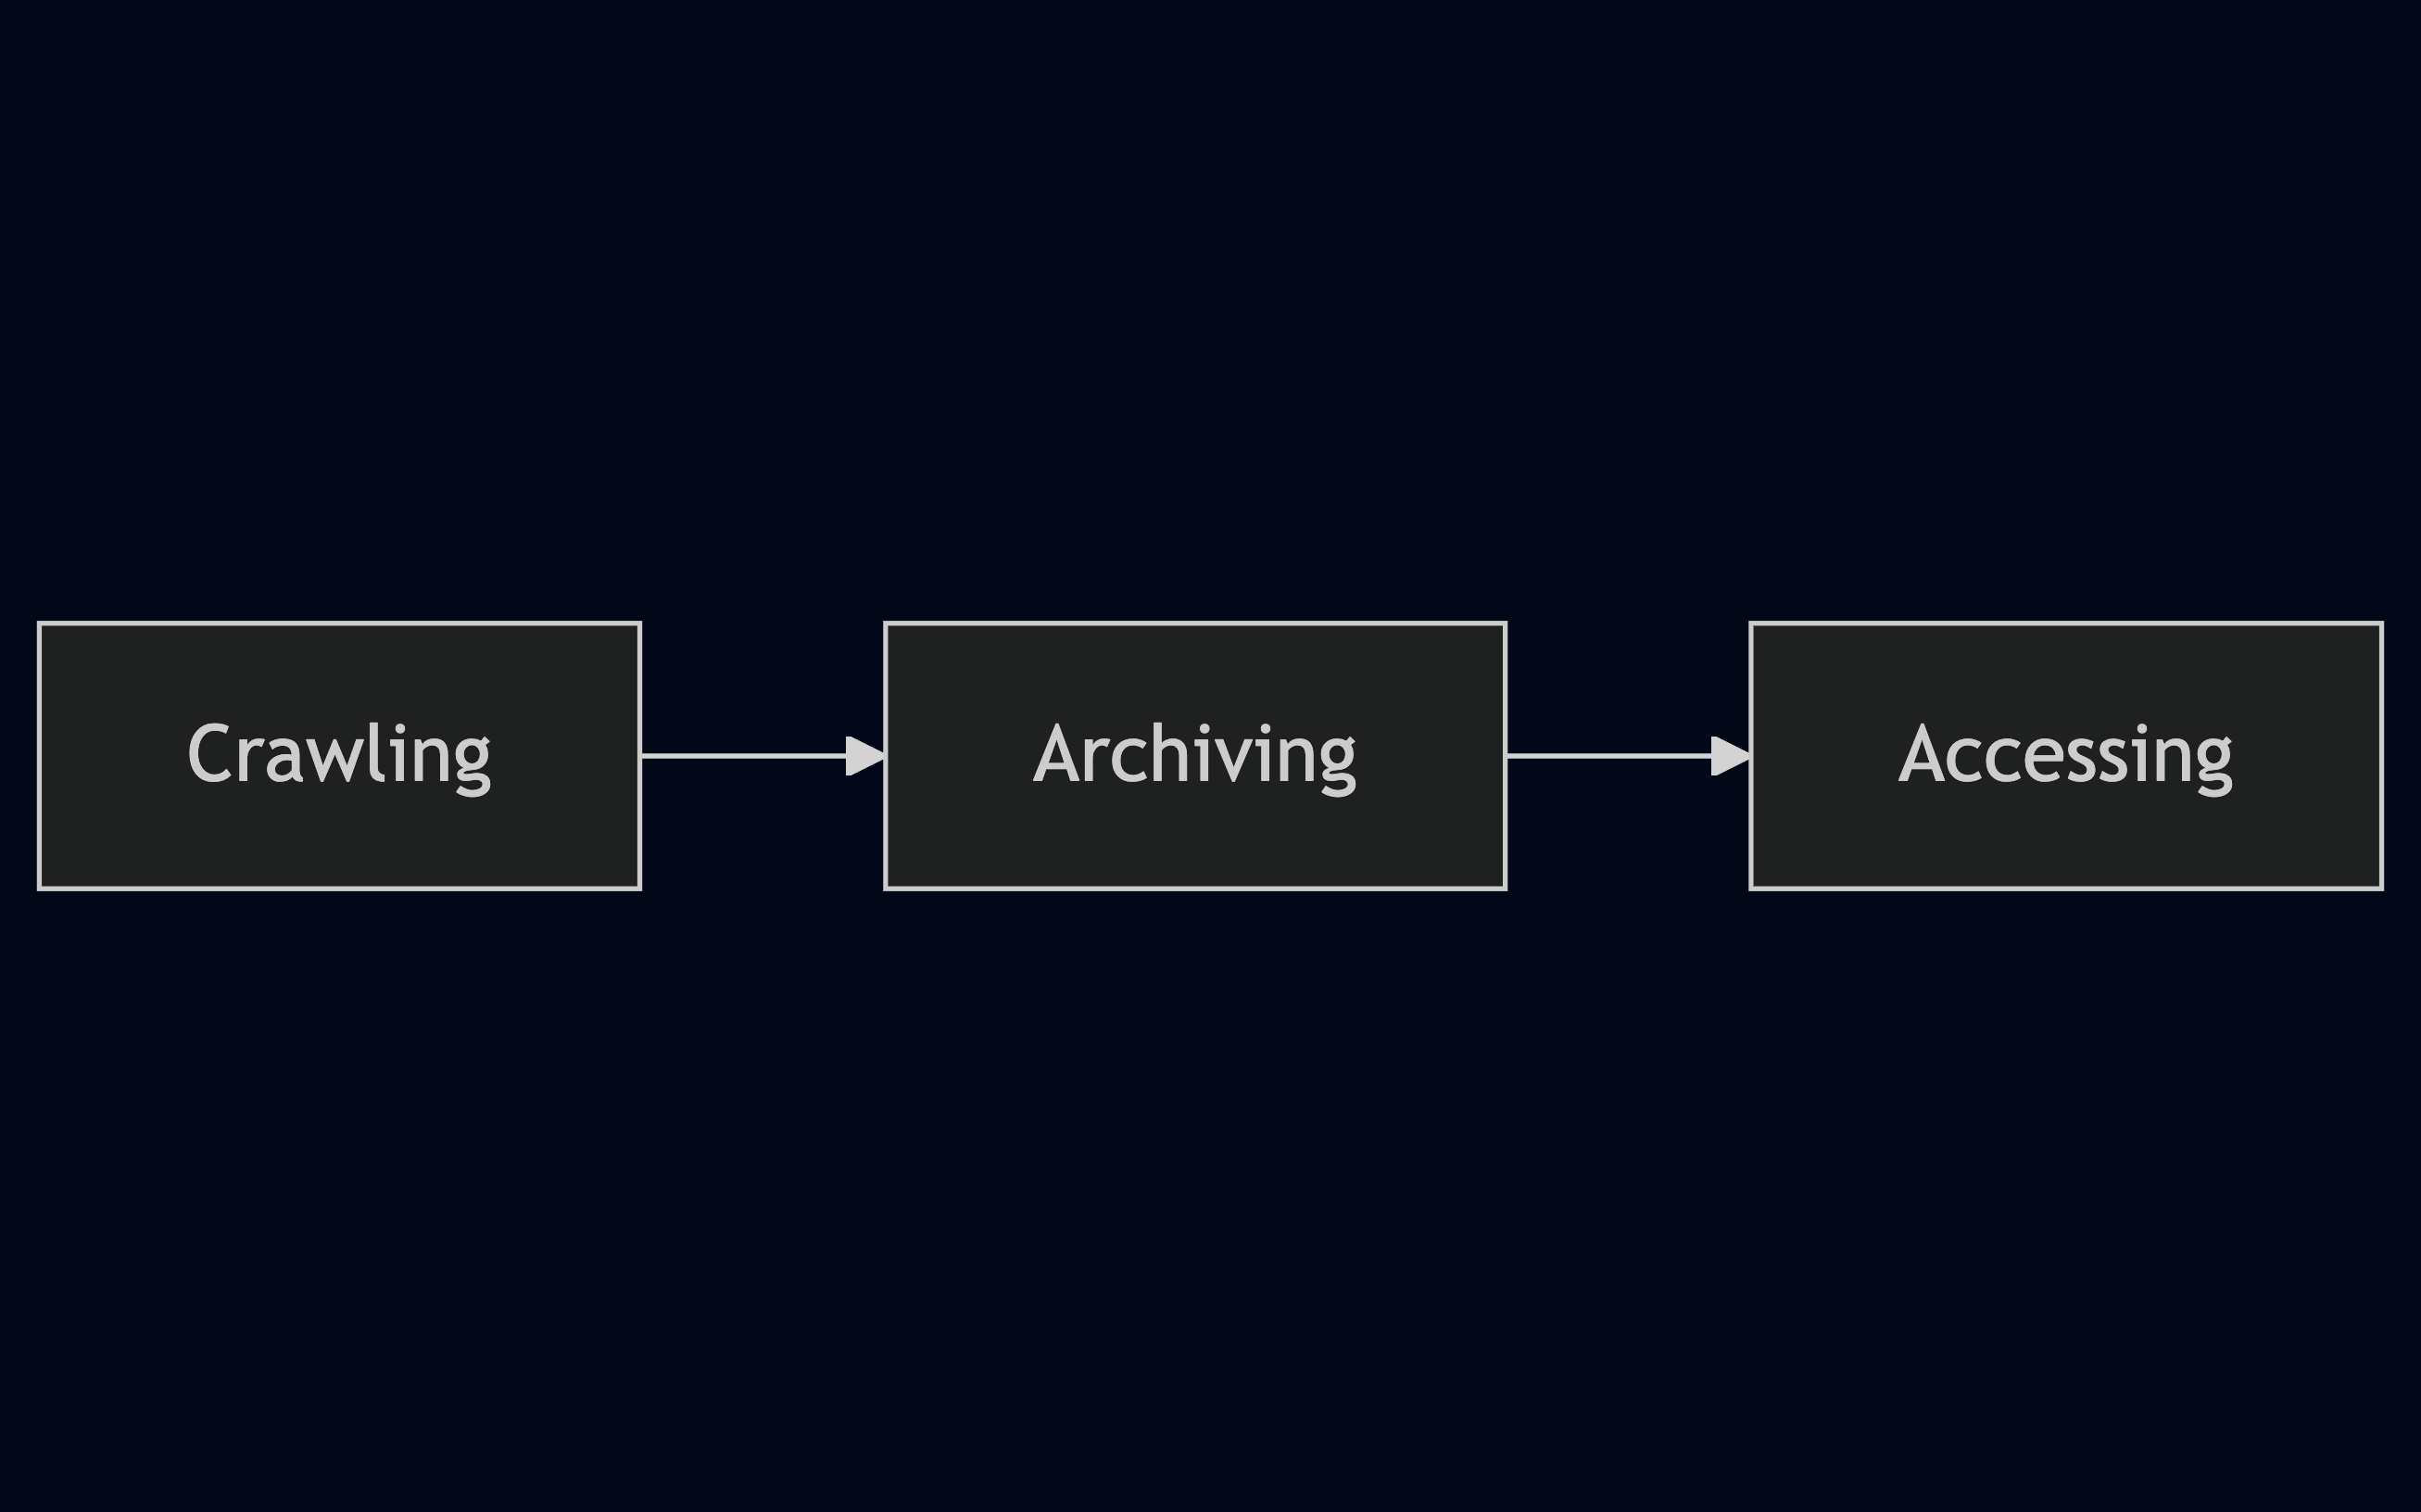
Wayback Machine 自 1996 年起保存网页历史快照。爬虫下载 HTML、CSS、JavaScript、图片等资源,并按时间存档,用户可按 URL 和日期访问。
对侦察的价值
- 找回已删除的页面、目录、文件和子域。
- 比较网站结构、技术与内容随时间的变化。
- 收集过去的人员、业务和技术选择信息。
- 在不接触当前目标基础设施的情况下进行被动侦察。
快照并不完整,抓取频率也不固定;存档内容可能缺资源或与当前系统无关。历史发现应作为线索,而非当前资产状态的直接证明。
18. 自动化侦察与 FinalRecon
自动化的主要优势是效率、可扩展性、结果一致性、覆盖面和工具集成。但自动化不会代替分析,还可能因默认线程数和模块组合产生大量流量。
课程列出的框架:FinalRecon、Recon-ng、theHarvester、SpiderFoot 和 OSINT Framework。
FinalRecon 首次安装
git clone https://github.com/thewhiteh4t/FinalRecon.git
cd FinalRecon
pip3 install -r requirements.txt
chmod +x ./finalrecon.py
./finalrecon.py --help
主要模块
- --headers:HTTP 头。
- --sslinfo:证书信息。
- --whois:WHOIS。
- --crawl:页面与资源爬取。
- --dns:DNS 记录。
- --sub:子域发现。
- --dir:目录枚举。
- --wayback:历史 URL。
- --ps:快速端口扫描。
- --full:综合侦察。
实际使用示例
先用低影响模块确认目标和输出,再按需要扩大范围:
./finalrecon.py --headers --whois --url http://inlanefreight.com
结果中会汇总目标 IP、响应头、服务器技术和 WHOIS,并导出到用户目录下的 FinalRecon dumps 文件夹。课程示例表明同一执行可把 Banner 和注册信息并列,便于关联;但每个结论仍需回到原始工具验证。
19. 技能评估
评估要求综合使用:
- whois。
- 分析 robots.txt。
- 子域名暴力枚举。
- 爬取并分析结果。
- 将发现的子域名加入 hosts 文件。
建议解题流程(不含答案)
- 对给定主域执行 WHOIS,记录 NS、注册商、日期和组织信息。
- 查询 A/AAAA、NS、MX、TXT 和 SOA,建立最初资产表。
- 访问根站及 /robots.txt,提取禁止路径和 Sitemap。
- 使用课程指定词表执行 dnsenum 子域枚举。
- 将有效子域按 <目标IP> <子域> 加入 /etc/hosts。
- 对每个 VHost 手工访问,比较标题、状态码、响应大小和技术栈。
- 使用 ReconSpider 爬取目标,分析 results.json 的链接、JS、文件、邮箱、表单与注释。
- 将新路径、子域和线索再次投入 DNS、VHost 及手工查询。
- 只提交题目要求的证据,不进行与目标无关的高噪声扫描。
20. 一套可复用的 Web 侦察顺序
授权范围
  ↓
WHOIS 与搜索引擎(被动)
  ↓
DNS 记录、CT 日志、历史存档
  ↓
子域解析与区域传送检查
  ↓
hosts 映射、VHost 枚举
  ↓
HTTP 头、重定向、WAF 与技术指纹
  ↓
robots.txt、Sitemap、.well-known
  ↓
受控爬取与 results.json 分析
  ↓
交叉验证、去重、形成资产和假设清单
21. 工具速查
目标 起手命令 域名注册信息 whois <域名> DNS 简洁解析 dig +short <域名> 指定记录 dig <域名> MX / NS / TXT / SOA 完整解析路径 dig +trace <域名> 反向解析 dig -x 子域字典枚举 dnsenum --enum <域名> -f <词表> -r 区域传送 dig axfr @ <域名> VHost 枚举 gobuster vhost -u -w <词表> --append-domain CT 日志 `curl ...crt.sh... HTTP 头 curl -I WAF 判断 wafw00f <域名> Web 基础扫描 nikto -h <域名> -Tuning b 自定义爬取 python3 ReconSpider.py 自动化低影响起步 finalrecon.py --headers --whois --url
22. 注意事项与结果记录
- 先确认授权范围;第三方 CDN、托管平台和外部链接不一定在范围内。
- 区分“历史存在”“当前可解析”“端口可达”“应用可用”四种状态。
- 控制线程、递归深度和请求间隔;dnsenum -r、Gobuster、Nikto、爬虫和 --full 都可能产生大量流量。
- -k、忽略证书错误、hosts 强制映射仅适合受控验证,不能证明真实 DNS/TLS 配置正确。
- WHOIS 隐私隐藏、Banner、WAF 识别、Nikto 告警和自动化框架结果都可能不完整或误报。
- 记录来源、时间、原始命令、响应状态、验证方式和结论置信度。
推荐记录模板:
### <域名 / 子域 / VHost>
- 来源:WHOIS / DNS / CT / 搜索引擎 / 存档 / 爬虫
- 当前解析:
- 历史记录:
- IP 与端口:
- HTTP 状态和重定向:
- 服务器 / CMS / WAF:
- robots.txt / Sitemap / .well-known:
- 相关文件、JS、邮箱和表单:
- 已验证事实:
- 尚待验证假设:
- 下一步: